UPDF
 IvyCraft
 AI 网页版
 Windows 版
 Mac 版
 iOS 版
 安卓版


 AI 单文件总结
 AI 多文件总结
 生成思维导图
 深度研究
 论文搜索
 AI 翻译
 AI 解释
 AI 问答
 编辑 PDF
 注释 PDF
 阅读 PDF
 PDF 表单编辑
 PDF 去水印
 PDF 添加水印
 OCR 图文识别
 合并 PDF
 拆分 PDF
 压缩 PDF
 分割 PDF
 插入 PDF
 提取 PDF
 替换 PDF
 PDF 加密
 PDF 密文
 PDF 签名
 PDF 文档对比
 PDF 打印
 批量处理
 发票助手
 PDF 共享
 云端同步
 PDF 转 Word
 PDF 转 PPT
 PDF 转 Excel
 PDF 转 图片
 PDF 转 TXT
 PDF 转 XML
 PDF 转 CSV
 PDF 转 RTF
 PDF 转 HTML
 PDF 转 PDF/A
 PDF 转 OFD
 CAJ 转 PDF
 Word 转 PDF
 PPT 转 PDF
 Excel 转 PDF
 图片 转 PDF
 Visio 转 PDF
 OFD 转 PDF
 创建 PDF
 AI 生成书签
 AI 总结书签
 AI 生成水印
 AI 生成背景
 AI 生成贴纸
 AI 生成印章
 AI 编辑与润色
 UPDF Copilot
 AI 页面检查
 AI 语义搜索
 PDF 转 Word
 PDF 转 Excel
 PDF 转 PPT
 企业解决方案
 企业版定价
 企业版 AI
 企业指南
 渠道合作
 信创版
 金融
 制造
 医疗
 教育
 保险
 法律
 政务

 常见问题
 新闻中心
 文章资讯
 产品动态
 更新日志
 科研指南








扫描版PDF不能直接编辑,通常是因为页面内容本质上是一张图片,里面的文字没有真正的文本层,所以会出现文字点不动、选不中、不能复制、无法搜索的问题。
想编辑扫描版 PDF,正确方法是:先用 UPDF 做 PDF OCR识别,把图片文字转换成可编辑、可复制、可搜索的文本,再继续修改文字、复制内容、搜索关键词,或者转成 Word 继续整理。
简单来说:
扫描版PDF文字点不动 → 先OCR识别 → 生成可编辑PDF → 再修改文字、复制内容或转Word如果你遇到的是文字复制不了,可以先看 pdf文字不能复制;如果 OCR 后还需要改正文内容,可以继续使用 PDF修改文字功能。
一、为什么扫描版PDF不能直接编辑?
扫描版 PDF 看起来像普通 PDF,但它和普通文本 PDF 不一样。普通 PDF 里的文字可以被选中、复制、搜索和编辑;扫描版 PDF 里的文字通常只是图片上的内容。
- 页面内容本质是图片
扫描件通常来自扫描仪、手机扫描 App、截图、图片导出等方式。虽然文件格式是 PDF,但页面内容更像一张图片。
所以你看到的“文字”,实际上不是可编辑文字,而是图片里的一部分。
常见表现包括:
- 鼠标无法选中文字;
- 点击文字没有光标;
- 复制不了正文;
- 搜索关键词搜不到;
- 放大后文字边缘像图片一样发虚;
- 无法像 Word 一样直接改字。
- 没有真实文字层
普通 PDF 里有文字层,软件可以识别每个字的位置和内容。扫描版 PDF 没有真实文字层,所以普通编辑功能无法直接修改。
这也是为什么很多人打开扫描合同、论文扫描件、教材 PDF 时,会发现文字完全点不动。
- 普通编辑工具无法选中文字
如果文件没有文字层,普通编辑工具只能识别整页图片,不能识别其中的文字。此时直接点击“编辑文字”通常没有效果。
解决方法不是手动覆盖文字,而是先用 OCR 把图片文字识别出来。
二、如何判断PDF是不是扫描版?
在编辑前,可以先用几个简单方法判断这份 PDF 是否属于扫描版。
- 看文字能不能选中
打开 PDF 后,用鼠标拖动正文中的一段文字。
如果能选中单个字、句子或段落,说明 PDF 可能有文本层;如果只能选中整块页面,或者完全选不中,那大概率是扫描版 PDF。
- 看关键词能不能搜索
按 Ctrl + F 搜索页面中明显出现的词,比如标题、人名、日期、公司名称等。
如果页面上明明有这个词,但搜索不到,说明文字很可能只是图片。
- 看复制是否为空或乱码
有些 PDF 看起来能选中,但复制出来为空、乱码或顺序混乱。这可能是文本层异常,也可以尝试重新 OCR 识别。
- 放大后看文字边缘
扫描版 PDF 放大后,文字边缘通常会像图片一样模糊,可能有像素感、灰边或扫描噪点。普通文本 PDF 放大后,文字通常依然清晰。
三、扫描版PDF怎么编辑?先用UPDF OCR识别
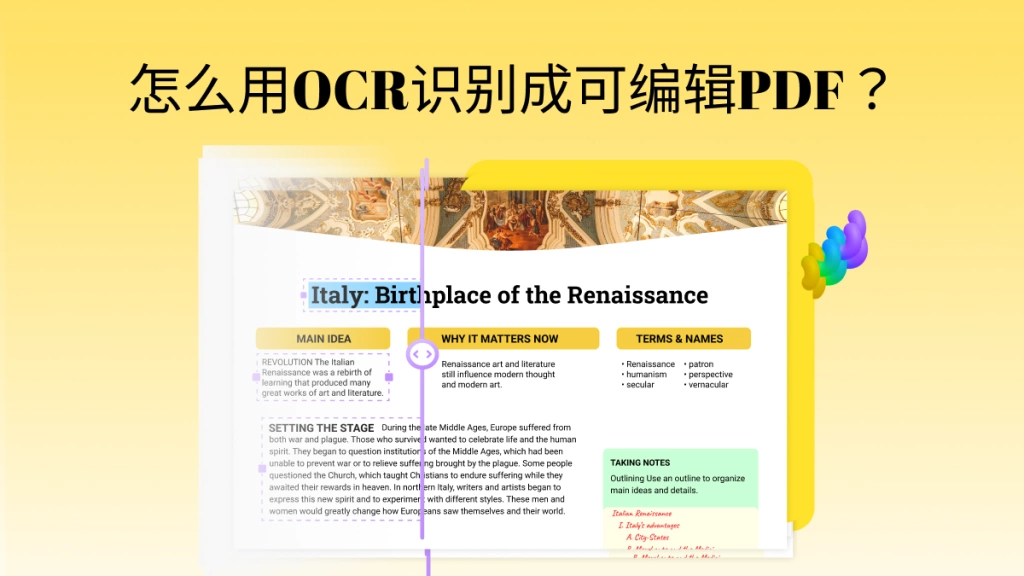
扫描版PDF编辑的关键步骤是 OCR。OCR 识别后,PDF 才能从“图片版文档”变成“可编辑文档”。
UPDF 提供两种入口:一种是打开文档后进入 OCR;另一种是从首页工具直接进入 OCR 批量处理。
- 打开PDF后进入OCR功能
先用 UPDF 打开扫描版 PDF。如果你发现页面文字不能选中,可以点击顶部的“工具”,在工具面板中找到“OCR”。

这个入口适合你已经打开文件,阅读过程中才发现文字无法编辑的情况。比如扫描论文、电子教材、合同扫描件、证明材料等,都可以从当前文档直接进入 OCR。
进入 OCR 后,建议选择“可编辑 PDF(双层 OCR)”。这个模式会保留原文档页面外观,同时为页面增加可编辑的文字层。
- 选择可编辑PDF双层OCR
OCR 识别时,UPDF 会提供不同模式。编辑扫描版 PDF 时,建议优先选择“可编辑 PDF(双层 OCR)”。
常见模式可以这样理解:
| OCR模式 | 适合场景 |
| 可编辑 PDF(双层 OCR) | 想修改文字、复制文字、搜索内容 |
| 仅文本和图片 | 想提取文本和图片内容 |
| 仅可搜索 PDF(双层 OCR) | 想保留原页面外观,同时让文字可搜索 |
如果你的目标是“编辑扫描版 PDF”,重点选“可编辑 PDF(双层 OCR)”。
- 选择文档语言
OCR 识别时,要选择正确的文档语言。中文资料选择简体中文,英文论文选择英文。如果文档是中英文混排,可以根据主要内容选择对应语言。
语言选错会影响识别效果,可能出现错字、乱码、标点错误或断行异常。
- 设置页面范围
如果只需要编辑其中几页,可以设置页面范围。比如只识别第 1-3 页,或者只识别合同正文部分。
如果整份 PDF 都是扫描件,可以选择全部页面。
- 点击转换或应用
设置完成后,点击“转换”或“应用”,UPDF 会开始识别扫描版 PDF 中的图片文字。

识别完成后,会生成带文字层的新 PDF。此时你就可以选中文字、复制内容、搜索关键词,也可以继续进行文字编辑。
四、从首页工具批量OCR识别扫描版PDF
如果你还没有打开 PDF,也可以直接从 UPDF 首页进入 OCR 功能。这种方式适合一次处理多个扫描版 PDF。
- 从首页进入OCR功能
打开 UPDF 后,在首页“工具”区域可以看到 OCR 入口。点击 OCR 后,会进入批量处理界面。

这种方式适合处理一批扫描文件,比如:
- 多份扫描合同;
- 多篇论文扫描件;
- 多个教材章节;
- 多张证明材料;
- 多份票据或发票;
- 多个图片版 PDF。
- 添加扫描版PDF文件
进入 OCR 批量处理界面后,点击“添加文件”,导入需要识别的扫描版 PDF。也可以把文件拖拽到页面中间区域。
如果有多个文件,可以一次添加多个 PDF,统一进行 OCR 识别。

- 选择OCR模式和语言
文件添加后,在右侧选择 OCR 文本识别模式。为了解决扫描版 PDF 不能编辑的问题,建议选择“可编辑 PDF(双层 OCR)”。
然后选择文档语言,比如简体中文。确认设置后点击“应用”,UPDF 就会开始识别文件。
- 生成可编辑PDF
识别完成后,扫描版 PDF 会生成新的可编辑版本。你可以重新打开文件,尝试选中文字、修改内容、搜索关键词,或者继续转成 Word 进行深度编辑。

五、OCR识别后可以编辑哪些内容?
扫描版 PDF 经过 OCR 识别后,就不再只是图片页面。你可以根据需要继续处理。
- 修改文字
OCR 后可以选中文字,并继续修改正文内容。比如改错别字、替换姓名、调整日期、修改标题等。
如果你想看更具体的文字修改教程,可以参考 PDF修改文字。
- 复制文字
OCR 后,原本不能复制的文字可以被选中和复制。这对论文阅读、合同整理、教材摘录、资料整理都很有用。
如果你的核心问题是复制不了文字,可以查看 pdf文字不能复制。
- 搜索关键词
扫描版 PDF OCR 后,可以用关键词搜索内容。比如搜索合同金额、公司名称、论文关键词、发票抬头等。
这对长文档特别有帮助,因为不用再逐页翻找。
- 转Word继续编辑
如果扫描版 PDF 内容很多,或者需要大幅修改排版,可以先 OCR,再使用 PDF转Word,把内容转成 Word 文档继续编辑。
注意:扫描版 PDF 不建议直接转 Word。最好先 OCR 识别,否则转出来可能仍然是图片,无法正常编辑。
- 提取文字内容
如果只是想把扫描件中的文字整理出来,可以使用 PDF文字提取,把识别后的内容复制或整理到其他文档中。
- 调整页面顺序
扫描件经常出现页面顺序混乱、空白页、多余页的问题。OCR 后可以继续进行页面管理,比如删除页面、插入页面、调整顺序、提取指定页面等。
六、扫描版PDF编辑文字时要注意什么?
OCR 能解决扫描版 PDF 不能编辑的问题,但识别效果会受到文件质量影响。编辑前后建议注意下面几点。
- 识别语言要选对
中文文档选中文,英文论文选英文,中英混排文档根据主要内容选择语言。语言选错会明显影响识别准确率。
- 扫描清晰度会影响识别结果
如果原始扫描件模糊、歪斜、阴影重、文字太小,OCR 识别效果会下降。扫描前尽量保证页面清晰、光线均匀、文字不歪。
- 复杂排版需要人工检查
表格、公式、双栏论文、脚注、图文混排的扫描件,OCR 后可能需要人工检查排版和文字顺序。
- 表格和公式可能需要重新整理
OCR 对普通正文识别更稳定,但复杂表格、数学公式、特殊符号可能需要手动调整。学术论文、财务表格、教材内容尤其要检查。
- 识别后先保存新文件
建议 OCR 后另存为新文件,不要覆盖原始扫描件。这样即使识别结果不理想,也可以回到原文件重新处理。
七、扫描版PDF可以直接转Word吗?
可以转,但不建议直接转。扫描版 PDF 本质是图片,如果不先 OCR,直接转 Word 后,内容可能仍然是图片,无法编辑。
更稳妥的流程是:
扫描版PDF → OCR识别 → 生成可编辑PDF → 再转Word这样转出的 Word 文档更容易编辑,文字也更容易复制和整理。
适合转 Word 的场景包括:
- 想大幅修改论文或教材内容;
- 想整理扫描合同条款;
- 想重新排版报告;
- 想提取长文档文字;
- 想把扫描件改成可编辑文档。
如果只是改少量文字,可以 OCR 后直接在 PDF 中编辑;如果要大幅修改内容,转 Word 会更方便。
八、扫描版PDF编辑常见场景
- 扫描合同
纸质合同扫描成 PDF 后,通常不能直接复制或修改。可以先 OCR,再搜索金额、日期、公司名称、条款内容,必要时继续修改文字。
- 论文扫描件
一些老论文、复印资料、扫描文献没有可选中文字。OCR 后可以搜索关键词、复制段落、整理引用和笔记。
- 电子教材
扫描版教材常常不能复制文字。OCR 后可以摘录重点内容,整理学习笔记,也可以搜索章节关键词。
- 证明材料
证明、申请表、证书、通知等文件如果是扫描件,可以通过 OCR 识别成可编辑内容,方便后续整理。
- 发票和票据
发票、收据、报销资料有时是图片版 PDF。OCR 后可以提取抬头、金额、日期和编号,方便整理和归档。
九、扫描版PDF怎么编辑和普通PDF编辑有什么区别?
普通 PDF 有真实文字层,打开后通常可以直接修改文字、复制内容、搜索关键词。扫描版 PDF 没有真实文字层,所以不能直接编辑。
| 文件类型 | 是否能直接编辑文字 | 处理方式 |
| 普通PDF | 通常可以 | 直接编辑文字 |
| 扫描版PDF | 通常不可以 | 先OCR识别,再编辑 |
| 图片版PDF | 通常不可以 | 先OCR识别,再复制或修改 |
| 文本层异常PDF | 可能乱码 | 重新OCR或转Word整理 |
所以,扫描版 PDF 编辑的关键不是直接改,而是先让它变成可编辑文档。
十、总结:扫描版PDF怎么编辑?
扫描版PDF不能直接编辑,是因为页面内容通常是图片,没有真实文字层。想编辑扫描版 PDF,需要先用 UPDF 做 OCR 识别,把图片文字转换成可编辑、可复制、可搜索的文本。
你可以在打开文档后点击“工具-OCR”,也可以从首页工具进入 OCR 批量处理。识别时建议选择“可编辑 PDF(双层 OCR)”,再选择文档语言和页面范围,点击转换或应用。OCR 完成后,就可以继续修改文字、复制内容、搜索关键词,或者转成 Word 进一步编辑。
对于扫描合同、论文扫描件、电子教材、证明材料、发票票据等文件,OCR 是编辑扫描版 PDF 的关键步骤。
FAQ:关于扫描版PDF编辑的常见问题
- 扫描版pdf怎么编辑?
扫描版 PDF 需要先用 OCR 识别,把图片文字转换成可编辑文本。识别完成后,就可以修改文字、复制内容、搜索关键词或转 Word 继续编辑。
- 扫描版PDF为什么文字点不动?
因为扫描版 PDF 的页面通常是图片,里面的文字不是真正的文本,所以无法直接选中和编辑。
- 扫描版PDF可以修改文字吗?
可以,但需要先 OCR。OCR 识别后,扫描件会生成可编辑文字层,再进行文字修改。
- 扫描版PDF可以复制文字吗?
默认不能直接复制。先用 OCR 识别后,文字就可以被选中和复制。
- 扫描版PDF可以转Word吗?
可以,但建议先 OCR 再转 Word。否则转出的 Word 可能仍然是图片,无法正常编辑。
- OCR识别后还需要检查吗?
需要。扫描清晰度、语言选择、表格、公式和复杂排版都会影响识别效果,识别完成后建议人工检查重点内容。