UPDF
 IvyCraft
 AI 网页版
 Windows 版
 Mac 版
 iOS 版
 安卓版


 AI 单文件总结
 AI 多文件总结
 生成思维导图
 深度研究
 论文搜索
 AI 翻译
 AI 解释
 AI 问答
 编辑 PDF
 注释 PDF
 阅读 PDF
 PDF 表单编辑
 PDF 去水印
 PDF 添加水印
 OCR 图文识别
 合并 PDF
 拆分 PDF
 压缩 PDF
 分割 PDF
 插入 PDF
 提取 PDF
 替换 PDF
 PDF 加密
 PDF 密文
 PDF 签名
 PDF 文档对比
 PDF 打印
 批量处理
 发票助手
 PDF 共享
 云端同步
 PDF 转 Word
 PDF 转 PPT
 PDF 转 Excel
 PDF 转 图片
 PDF 转 TXT
 PDF 转 XML
 PDF 转 CSV
 PDF 转 RTF
 PDF 转 HTML
 PDF 转 PDF/A
 PDF 转 OFD
 CAJ 转 PDF
 Word 转 PDF
 PPT 转 PDF
 Excel 转 PDF
 图片 转 PDF
 Visio 转 PDF
 OFD 转 PDF
 创建 PDF
 AI 生成书签
 AI 总结书签
 AI 生成水印
 AI 生成背景
 AI 生成贴纸
 AI 生成印章
 AI 编辑与润色
 UPDF Copilot
 AI 页面检查
 AI 语义搜索
 PDF 转 Word
 PDF 转 Excel
 PDF 转 PPT
 企业解决方案
 企业版定价
 企业版 AI
 企业指南
 渠道合作
 信创版
 金融
 制造
 医疗
 教育
 保险
 法律
 政务

 常见问题
 新闻中心
 文章资讯
 产品动态
 更新日志
 科研指南








年报PDF提取文字并保留页码,先判断目标页面是否已有可用文字层,再按段落或表格区域摘录,记录文件版本、印刷页码、PDF页序和原文上下文。只有扫描页或文字层异常时才考虑OCR。摘录后核对限定条件、单位和脚注,并把原文与个人概括分开保存。
这适合整理公开报告的研究助理、行业分析资料人员和写作人员。本文只讨论文档读取与来源管理,不评价公司价值、不作投资建议,也不把工具提取的数字当作已经完成财务核验的结果。
先判断需要摘录的页面,不要默认整份都要OCR
公开年报可能同时包含正文文本、扫描签章、图片图表和嵌入附件。先在目标段落尝试选中、搜索和复制一小段内容。如果文字正常,直接按任务摘录即可;盲目对整份报告重新识别,反而可能引入新的字符与顺序问题。
如果页面看得到字却选不中,或复制后出现乱码,再检查是否为扫描图像或异常文字层。若涉及文件权限,先确认允许使用的范围;不要把OCR当作绕过权限的办法。处理公开材料,也应遵守来源网站和文件本身的使用要求。
让一条摘录包含足够的来源信息
只保存一段文字和一个链接,几周后往往难以找回原位置。建议记录报告名称、披露主体、报告期间、文件版本或获取日期、章节、印刷页码、PDF页序及附近的表号。字段多少可以按任务调整,但至少要能让另一人找到相同段落。
尤其注意封面、目录和前言可能使用独立编号。PDF阅读器显示第35页,报告印刷页码可能是第29页,两者都不必强行改成一个。引用时遵守所采用的写作规范,内部工作记录则可以保留双重定位,减少查找歧义。
| 记录项 | 用途 | 容易遗漏的地方 |
|---|---|---|
| 文件与版本 | 确认用的是哪份报告 | 修订版、补充公告与旧副本混用 |
| 章节与页码 | 准确返回原段落 | 印刷页码与阅读器页序不同 |
| 完整原文 | 保留作者原始表述 | 删掉前置条件和例外说明 |
| 个人概括 | 表达自己的理解 | 混进原文列,之后误作直接引用 |
| 相关表号与脚注 | 连接数字与解释 | 正文数字与表格口径不一致 |
双栏页面要按阅读顺序摘录
一段文字跨越双栏或多个文本框时,一次全选可能把左栏和右栏交错粘贴。先从一个自然段开始,比较复制前后的句子顺序;确认正常后再扩大范围。对图注、旁注和表格,分别摘录比把整页清洗成一个长段落更稳妥。
页眉、页脚和行末断词也可能混入结果。可以清理明显重复的页面标记,但先确认它们不是报告正文的一部分。英文词在换行处被拆开时,要按原文核对后再连接;涉及产品名、缩写和连字符编码时,不能统一删掉所有连字符。
例如演示句“在既定统计范围内,本期相关数量较上期有所增加”,不能只摘成“相关数量增加”。如果上一段定义了统计范围,下一段说明口径变化,应把必要背景一起记录。这里的句子是说明摘录边界的示例,不是任何公司的披露内容。
扫描页需要识别时,保留可核对的原页面
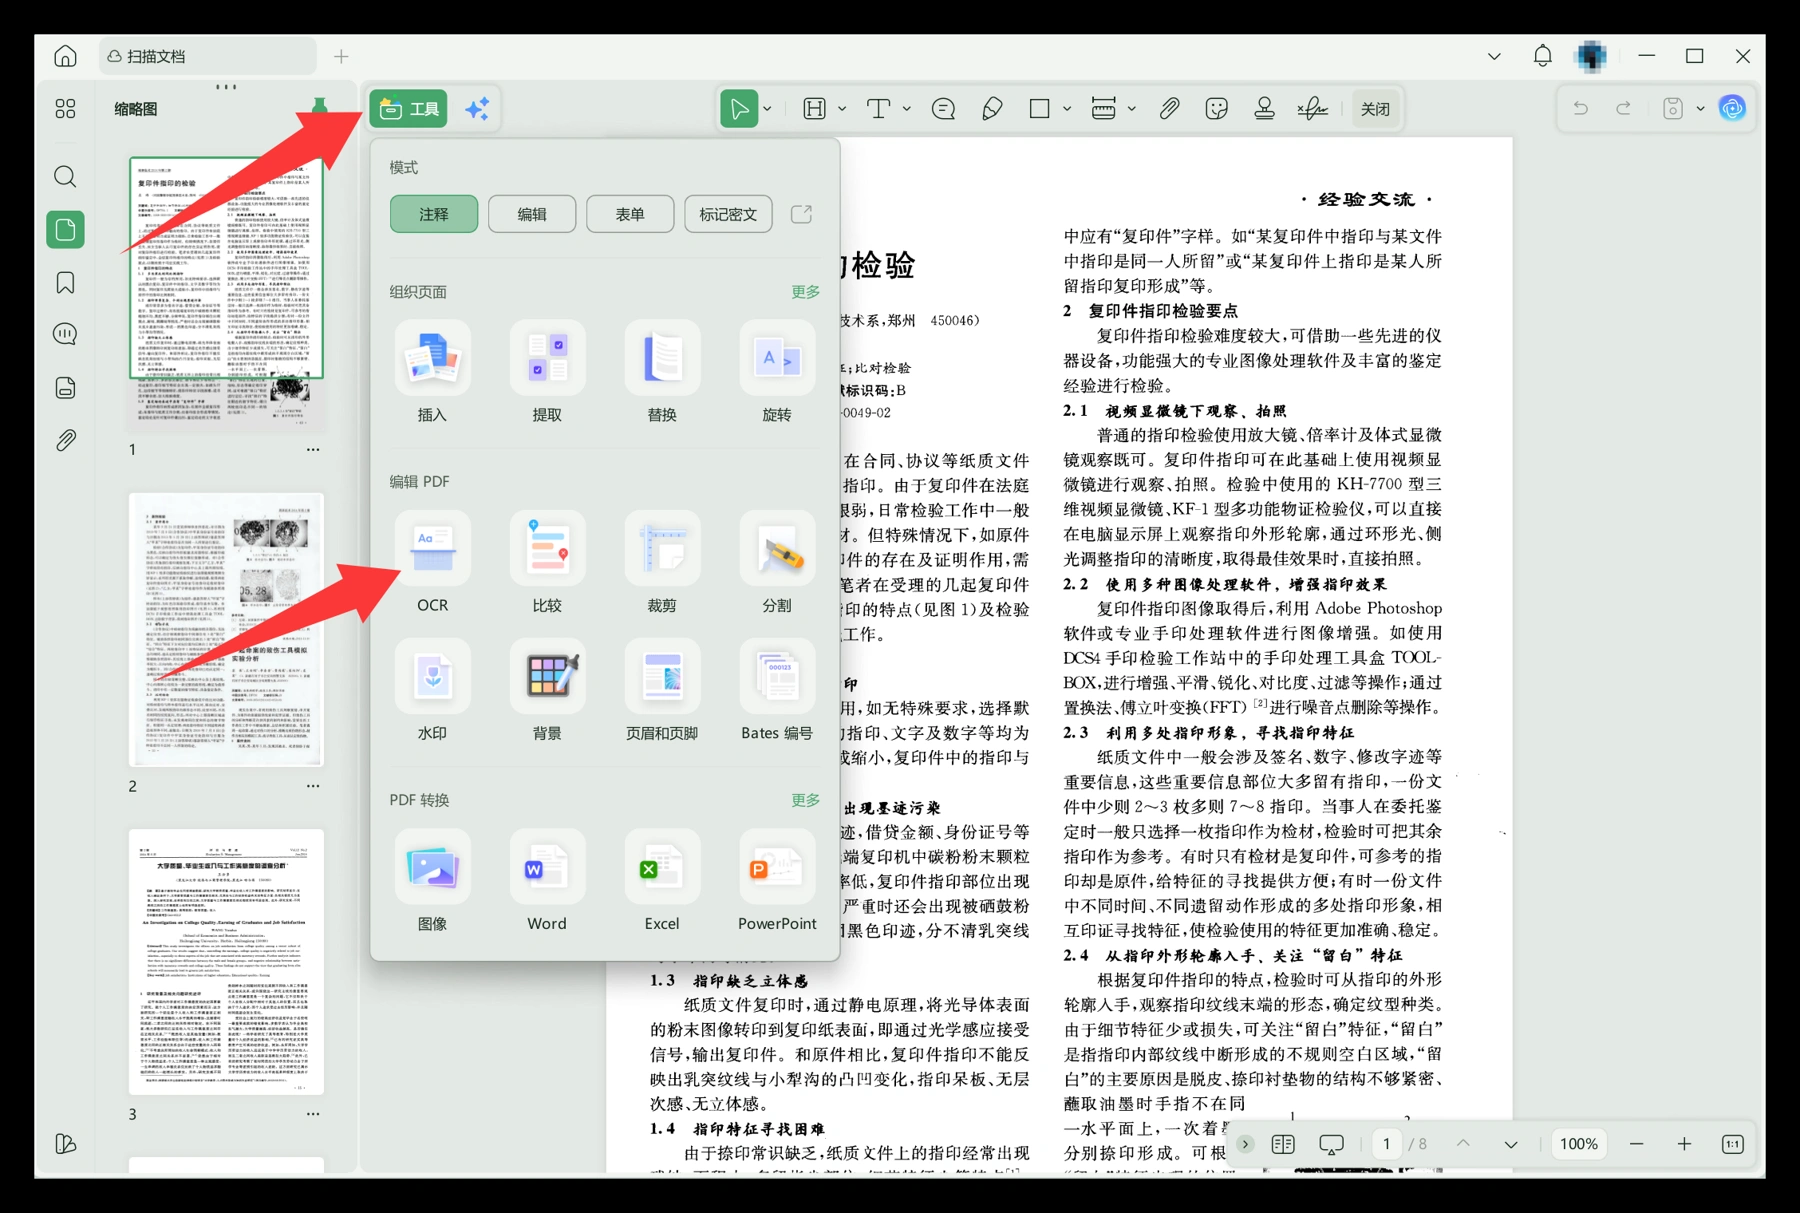
使用UPDF打开副本,从OCR中选择对应语言和页面范围。只处理需要引用的扫描页,可以减少不必要的转换;若要建立整份报告的检索副本,再按实际需要扩大范围。识别结果另存,不覆盖下载得到的原文件。
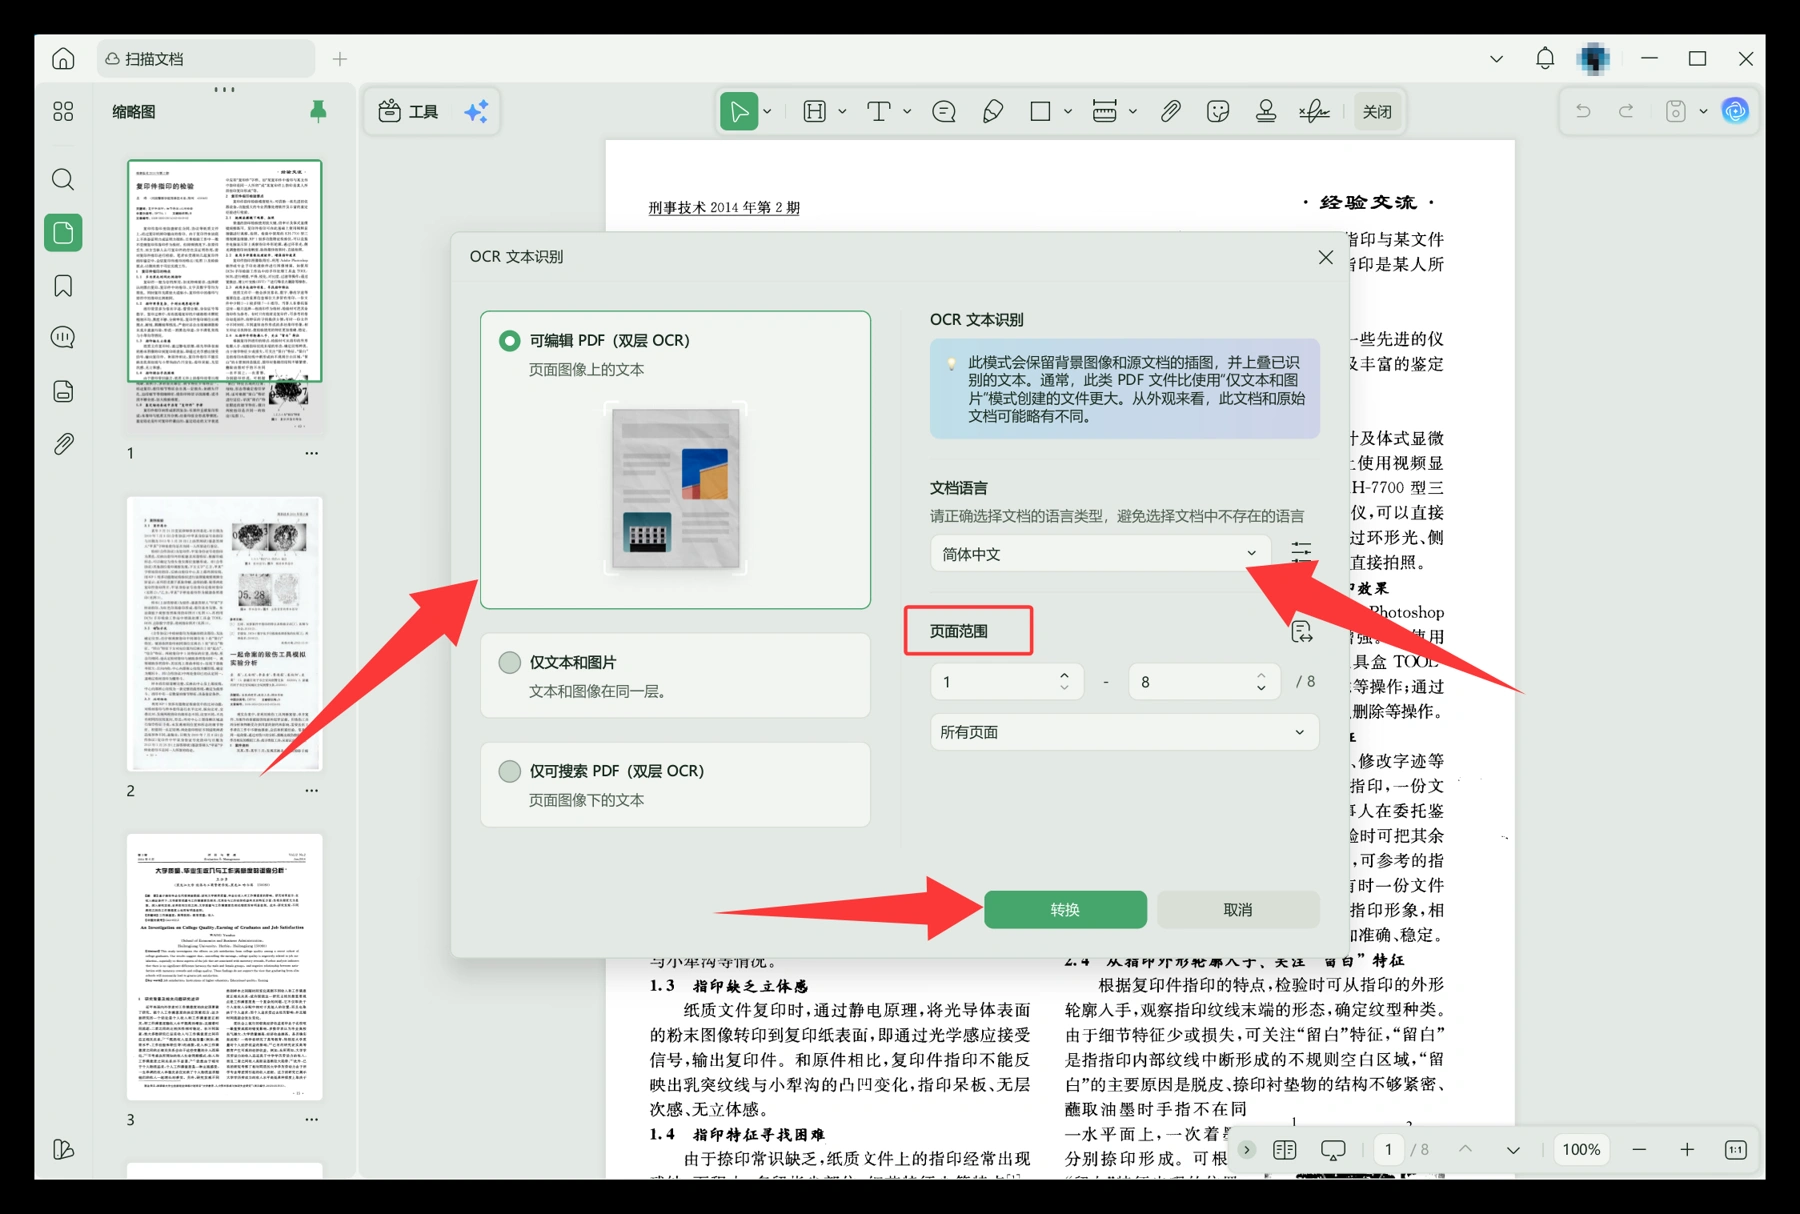
识别后用一个明确词语测试搜索,再复制目标段落与原图核对。常见问题包括小数点、负号、括号、脚注标记和相似字符。不能因为复制出的文本没有乱码,就认定数字和原文完全一致;涉及后续分析的关键内容,应回到报告及相应原始说明确认。
表格数据必须连同单位与脚注读取
同一份报告里,不同表格可能使用不同单位、统计对象和时间口径。复制某个数值时,至少保留行名、列名、单位和脚注。不要把“报告期末”与“报告期内”混为一类,也不要把不同统计范围的数字直接并列而不作说明。
提取文字和提取结构化表格是不同任务。若需要做计算,应单独核对表格结构,检查空白值、破折号、括号和负值是否被正确理解;必要时由熟悉资料的人复核。本文不提供财务指标解释,文档工具也不能替代相应专业判断。
把“引用”“概括”和“待核实判断”分开
工作表中可以设置三个不同区域:原文摘录、个人概括、待核实问题。原文列保持与来源一致;概括列说明自己的理解;问题列记录口径疑点或缺失资料。这样后来写报告时,不容易把自己顺手归纳的一句话误认为企业原话。
若使用AI辅助总结,也应把生成内容放在概括或待核对区域,并追溯原文。不要因为AI给出流畅的段落,就省略页码和来源。对未公开或受限制资料,不应直接上传云端问答;本文演示流程可以用公开、获许可的样本完成。
相关工具可查看PDF格式转换和OCR图文识别。需要理解特定输出格式的步骤时,可参考PDF转TXT教程,但导出的纯文本仍需另行维护来源页码。
常见问题
转成TXT后,页码会自动保留下来吗?
不能假定一定保留可用的定位关系。纯文本主要保存字符,页面结构可能变化。因此重要摘录应在转换前后单独记录章节、印刷页码和PDF页序,并检查最终文本是否对应原段落。
年报里的数字可以复制后直接用于分析吗?
应先核对原文、单位、时间和统计范围,必要时回查表格及脚注。文字提取成功并不等于财务数据或解释已经验证。后续专业分析应使用合适的方法和核验流程。
只引用一句话,是否还要看前后段?
需要。前文定义、后文限制和表格注释可能决定这句话适用于什么范围。为了简短而删掉条件,可能改变原始含义;至少应保留能够说明引用边界的工作记录。
年报PDF提取文字保留页码的重点,是让每条资料都能回到具体版本和原始位置。先确认文字层,再按阅读顺序摘录、连同脚注核对,并把引用与个人理解分开,资料整理才不会在后续写作中失去依据。