UPDF
 IvyCraft
 AI 网页版
 Windows 版
 Mac 版
 iOS 版
 安卓版


 AI 单文件总结
 AI 多文件总结
 生成思维导图
 深度研究
 论文搜索
 AI 翻译
 AI 解释
 AI 问答
 编辑 PDF
 注释 PDF
 阅读 PDF
 PDF 表单编辑
 PDF 去水印
 PDF 添加水印
 OCR 图文识别
 合并 PDF
 拆分 PDF
 压缩 PDF
 分割 PDF
 插入 PDF
 提取 PDF
 替换 PDF
 PDF 加密
 PDF 密文
 PDF 签名
 PDF 文档对比
 PDF 打印
 批量处理
 发票助手
 PDF 共享
 云端同步
 PDF 转 Word
 PDF 转 PPT
 PDF 转 Excel
 PDF 转 图片
 PDF 转 TXT
 PDF 转 XML
 PDF 转 CSV
 PDF 转 RTF
 PDF 转 HTML
 PDF 转 PDF/A
 PDF 转 OFD
 CAJ 转 PDF
 Word 转 PDF
 PPT 转 PDF
 Excel 转 PDF
 图片 转 PDF
 Visio 转 PDF
 OFD 转 PDF
 创建 PDF
 AI 生成书签
 AI 总结书签
 AI 生成水印
 AI 生成背景
 AI 生成贴纸
 AI 生成印章
 AI 编辑与润色
 UPDF Copilot
 AI 页面检查
 AI 语义搜索
 PDF 转 Word
 PDF 转 Excel
 PDF 转 PPT
 企业解决方案
 企业版定价
 企业版 AI
 企业指南
 渠道合作
 信创版
 金融
 制造
 医疗
 教育
 保险
 法律
 政务

 常见问题
 新闻中心
 文章资讯
 产品动态
 更新日志
 科研指南








下载了几十篇论文后,先不要按文件名顺序逐篇精读。更有效的方法是先写清研究问题,再看标题、摘要和研究方法,将文献分成“优先精读、相关泛读、暂不阅读”三组;对难以判断的论文,再打开全文检查图表和结论,并记录判断理由。
文献初筛的目的,是从一批候选论文中找出最能回答当前问题的文献。例如,你要研究某种方法在特定人群中的效果,相关论文不仅要讨论相近主题,还应考虑研究对象、方法、评价指标和实际应用场景是否匹配。
一、先明确自己的阅读任务
同一篇论文,对准备开题、复现实验和撰写综述的人,阅读优先级可能完全不同。整理文件前,先用一句话回答:我现在需要从文献里得到什么?
- 了解领域:先找覆盖研究脉络的综述和代表性研究。
- 寻找研究问题:关注论文讨论中的局限、未解决问题与后续研究方向。
- 学习方法:优先阅读与自己课题使用相似数据、实验设计或分析方法的研究。
- 准备复现:检查方法细节、数据来源、代码和实验条件是否可获得。
- 撰写综述:选择能够代表不同观点、研究方法和结论的论文,避免只收集支持单一观点的文章。
将研究对象、问题、方法和场景写成简短的筛选条件。比如“关注大学生在线学习中的学习投入,优先考虑包含实证数据的研究”。这不是固定标准,而是一把帮助你判断相关性的尺子。
二、第一轮:通过标题和摘要排除明显不相关的文献
第一轮可以只看标题、摘要和关键词。对于每篇论文,回答三个问题:研究对象是谁?研究什么问题?主要用了什么方法?如果三个问题都与当前任务差距较大,可以先归入“暂不阅读”。
不要因为标题出现同一个关键词就直接判定为核心文献。比如两篇文章都研究“学习投入”,一篇讨论中学生课堂,另一篇讨论企业员工培训,二者的变量名称相似,但应用场景和结论能否迁移,需要进一步判断。
遇到英文摘要,可以在UPDF中打开PDF,选择需要理解的文字进行翻译,或使用UPDF AI辅助理解。翻译后仍要对照原文,重点检查否定词、比较对象和专业术语,避免把“相关”误读成“因果”。
摘要里优先找什么?
通常可以从研究目的、样本或材料、方法、主要结果和作者结论五个位置入手。摘要没有说明的细节暂时标为“待核实”,不要自行补全。综述论文与实证论文的摘要结构可能不同,应根据文章类型调整判断。
三、第二轮:对可能相关的论文快速检查全文
标题和摘要能帮助排除明显不相关的论文,却不足以判断一篇研究是否适合引用。对于第一轮留下的候选文献,打开全文,优先检查引言、方法、主要图表和讨论部分。
| 位置 | 需要判断的问题 | 对排序的帮助 |
|---|---|---|
| 引言 | 作者研究的问题与自己的问题是否一致? | 判断论文是否切中主题 |
| 方法 | 研究对象、样本和方法是否适用? | 判断能否借鉴研究设计 |
| 图表与结果 | 论文用哪些数据支撑主要结论? | 判断证据是否与问题相关 |
| 讨论与局限 | 结论适用于什么条件?作者承认哪些限制? | 识别可引用范围和后续问题 |
| 参考文献 | 是否出现反复被引用的基础研究? | 发现需要补读的源头论文 |
例如,一篇论文标题与你的课题非常接近,但样本只来自单一地区,且测量指标与你准备使用的指标不同。它依然可能值得阅读,但借鉴其结论时应说明研究条件,而不是直接视为适用于所有场景。
四、建立文献初筛表,决定阅读顺序
筛选时建议记录论文标题、作者、年份、研究对象、方法、主要发现、相关性和下一步动作。表格可以放在电子表格或笔记工具中,也可以先在PDF上做标记,再集中整理。
| 文献 | 相关性判断 | 阅读安排 |
|---|---|---|
| 论文A:研究对象和方法都接近 | 能直接帮助设计研究 | 优先精读方法和结果 |
| 论文B:主题相近,样本不同 | 可用于比较不同场景 | 泛读,重点记录适用条件 |
| 论文C:关键词相同,研究问题不同 | 与当前任务关联较弱 | 暂存,后续有需要再看 |
上表是示例,具体排序应以你的研究任务为准。每篇文献只写“有用”还不够,最好补充一句原因,例如“变量定义可借鉴,但样本不一致”。几周后回看时,这句话比文件夹名称更能说明当初为什么保留它。
五、用UPDF加快单篇论文的初步理解
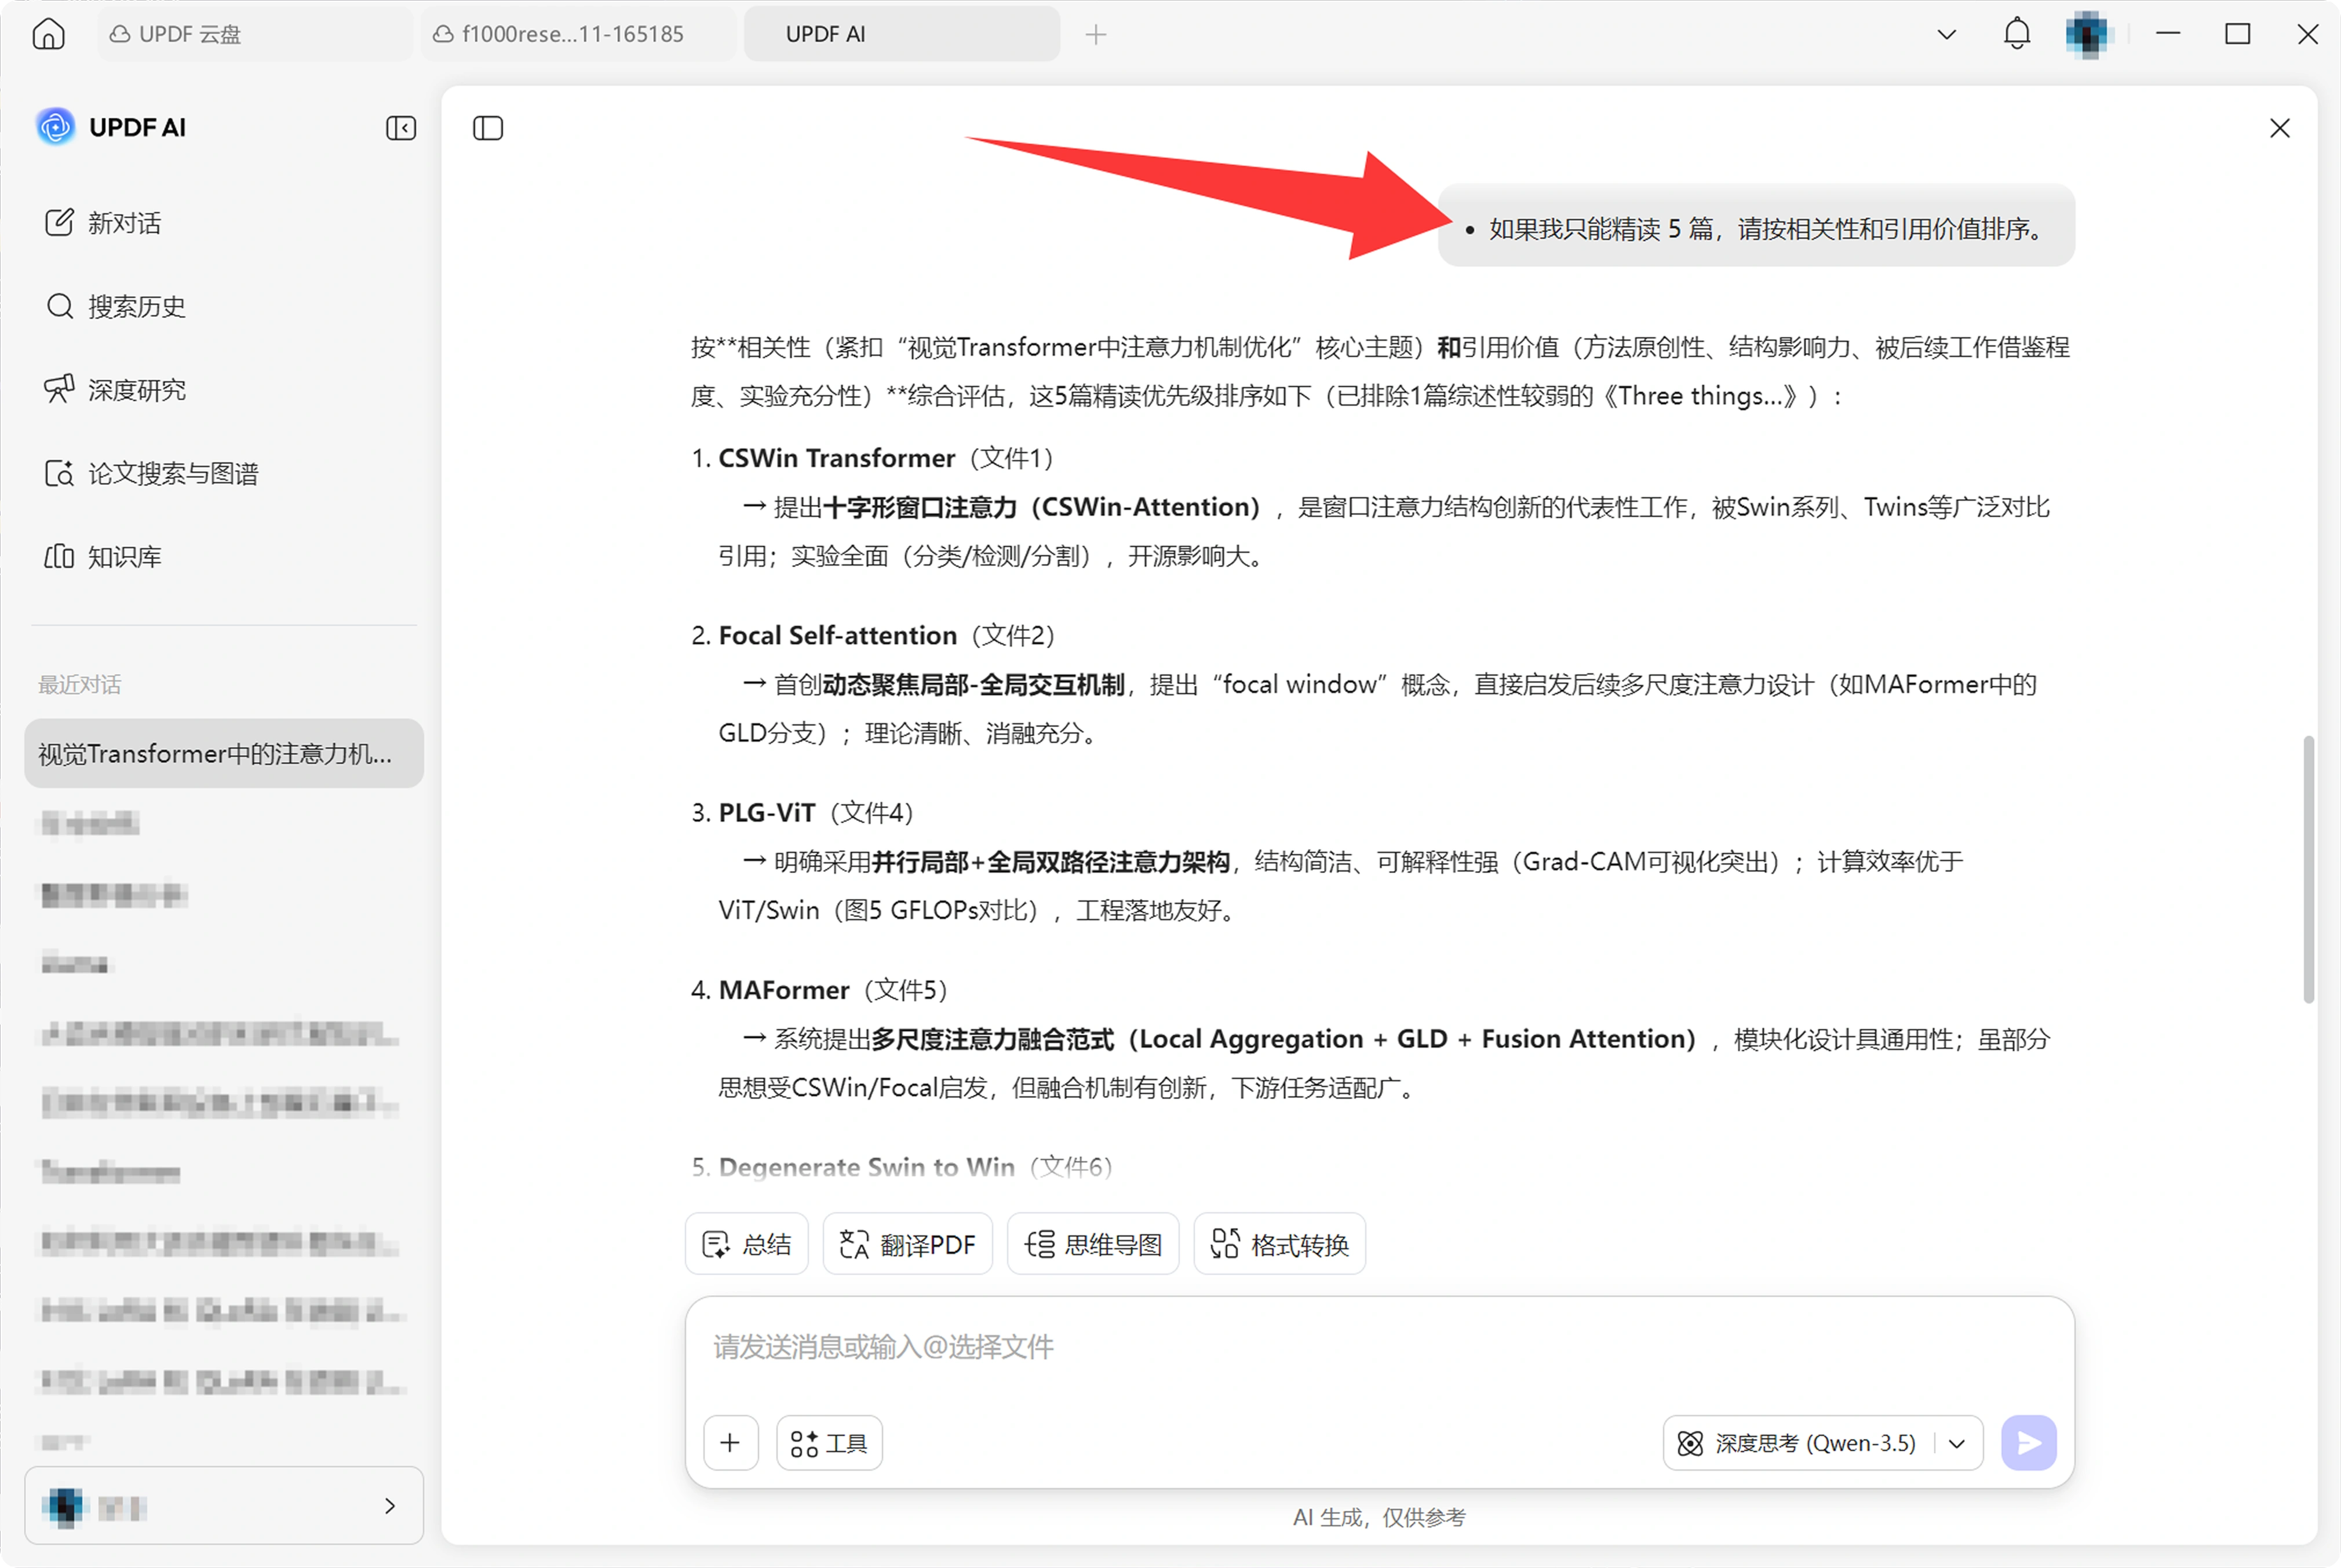
筛选时可以借助UPDF AI读PDF了解论文结构。打开文件后,围绕具体问题提问,比直接要求“总结全文”更有助于判断相关性。
例如可以输入:
- 请概括论文研究对象、研究问题、方法和主要结论,并说明相关内容出现在哪些部分。
- 这项研究使用了什么样本或数据?作者是否说明了选择范围?
- 作者讨论了哪些研究局限?请区分论文明确写出的内容和你的解释。
- 我关注的是某个具体研究问题,这篇文章有哪些直接相关和不相关的部分?
把问题中的研究对象、领域和方法替换成自己的实际情况。AI回答适合帮助定位线索,但不能代替阅读:关键结论、数字和引文应回到原文核对。对扫描版PDF,识别质量也会影响内容读取,必要时先进行OCR再检查原文。
如果已将多篇论文加入UPDF AI,也可以请它按照相关性整理优先阅读顺序,再逐篇核对排序依据和原文。
六、初筛之后怎么安排精读?
将高优先级论文安排在专注时间阅读,每次带着一个明确的问题。例如读方法时只记录样本选择、变量定义和分析流程;读结果时只记录核心图表、比较对象和结论边界。阅读后用自己的话写一段简短总结,并保留原文页码,方便之后核对。
泛读文献可以先看摘要、引言和讨论,只记录它与核心文献的差异。遇到重要的矛盾结论,再回到方法和数据部分寻找原因。相关文献还可以结合多篇论文对比方法,按研究对象、方法和结果横向整理。
常见问题
文献初筛只看摘要够吗?
摘要适合第一轮判断,但无法完整呈现样本、实验条件和证据细节。准备引用或借鉴方法时,应阅读全文相关部分,并核对图表和研究限制。
被引用次数高的论文一定要先读吗?
不一定。引用情况可以作为线索,但相关性、发表背景和研究目的同样重要。基础研究、近期研究与综述可以搭配阅读,避免只按单一指标排序。
筛掉的论文需要删除吗?
不必马上删除。可以单独存放并记录暂不阅读的原因;当研究问题发生变化时,再回头检查是否需要重新纳入。
AI总结可以直接作为论文引用吗?
不建议把AI生成的概括当成原文证据。应找到原论文对应内容,核实结论和页码,再按所在学校或期刊要求引用原始文献。
文献初筛不追求一次判断完美,而是让每篇论文都有清楚的下一步:精读、泛读、暂存或补充核实。先确定研究问题,再分轮筛选、记录理由并回到原文验证,就能逐步把一堆PDF变成有顺序的阅读清单。