UPDF
 IvyCraft
 AI 网页版
 Windows 版
 Mac 版
 iOS 版
 安卓版


 AI 单文件总结
 AI 多文件总结
 生成思维导图
 深度研究
 论文搜索
 AI 翻译
 AI 解释
 AI 问答
 编辑 PDF
 注释 PDF
 阅读 PDF
 PDF 表单编辑
 PDF 去水印
 PDF 添加水印
 OCR 图文识别
 合并 PDF
 拆分 PDF
 压缩 PDF
 分割 PDF
 插入 PDF
 提取 PDF
 替换 PDF
 PDF 加密
 PDF 密文
 PDF 签名
 PDF 文档对比
 PDF 打印
 批量处理
 发票助手
 PDF 共享
 云端同步
 PDF 转 Word
 PDF 转 PPT
 PDF 转 Excel
 PDF 转 图片
 PDF 转 TXT
 PDF 转 XML
 PDF 转 CSV
 PDF 转 RTF
 PDF 转 HTML
 PDF 转 PDF/A
 PDF 转 OFD
 CAJ 转 PDF
 Word 转 PDF
 PPT 转 PDF
 Excel 转 PDF
 图片 转 PDF
 Visio 转 PDF
 OFD 转 PDF
 创建 PDF
 AI 生成书签
 AI 总结书签
 AI 生成水印
 AI 生成背景
 AI 生成贴纸
 AI 生成印章
 AI 编辑与润色
 UPDF Copilot
 AI 页面检查
 AI 语义搜索
 PDF 转 Word
 PDF 转 Excel
 PDF 转 PPT
 企业解决方案
 企业版定价
 企业版 AI
 企业指南
 渠道合作
 信创版
 金融
 制造
 医疗
 教育
 保险
 法律
 政务

 常见问题
 新闻中心
 文章资讯
 产品动态
 更新日志
 科研指南








扫描版PDF不能像普通PDF一样直接改字。正确流程是:先用UPDF做 PDF OCR识别,选择“可编辑PDF(双层OCR)”,把图片文字识别成真实文本,再继续复制、搜索、修改文字或转成Word。
扫描版PDF文字点不动 → OCR识别 → 生成可编辑PDF → 修改文字、复制内容、搜索关键词或转Word如果你的问题是文字完全选不中、复制不了,可以先看 pdf文字不能复制;如果已经识别完成,后续想改正文内容,可以参考 PDF修改文字。
一、先判断你的PDF是不是扫描版
打开PDF后,先做三个测试,不需要先研究复杂概念。
| 测试方法 | 结果 | 说明 |
| 用鼠标拖动正文 | 选不中具体文字 | 大概率是扫描版或图片版PDF |
| 按 Ctrl + F 搜索标题词 | 页面有文字但搜不到 | PDF里没有真实文本层 |
| 复制一段内容 | 为空、乱码或顺序混乱 | 文本层异常,需要重新OCR |
扫描版PDF常见于纸质合同扫描件、论文扫描件、电子教材、证明材料、发票票据、手机拍照生成的PDF。它的页面看起来有文字,但软件识别到的往往是一整张图片。
二、方法一:打开PDF后直接进入UPDF OCR
如果你已经打开了扫描版PDF,发现文字点不动,可以直接从当前文档进入OCR。
1. 用UPDF打开PDF,点击“工具-OCR”
打开文件后,点击顶部“工具”,找到“OCR”。这个入口适合你正在阅读PDF时临时发现文件不能编辑的情况,比如扫描合同、扫描论文、教材PDF等。
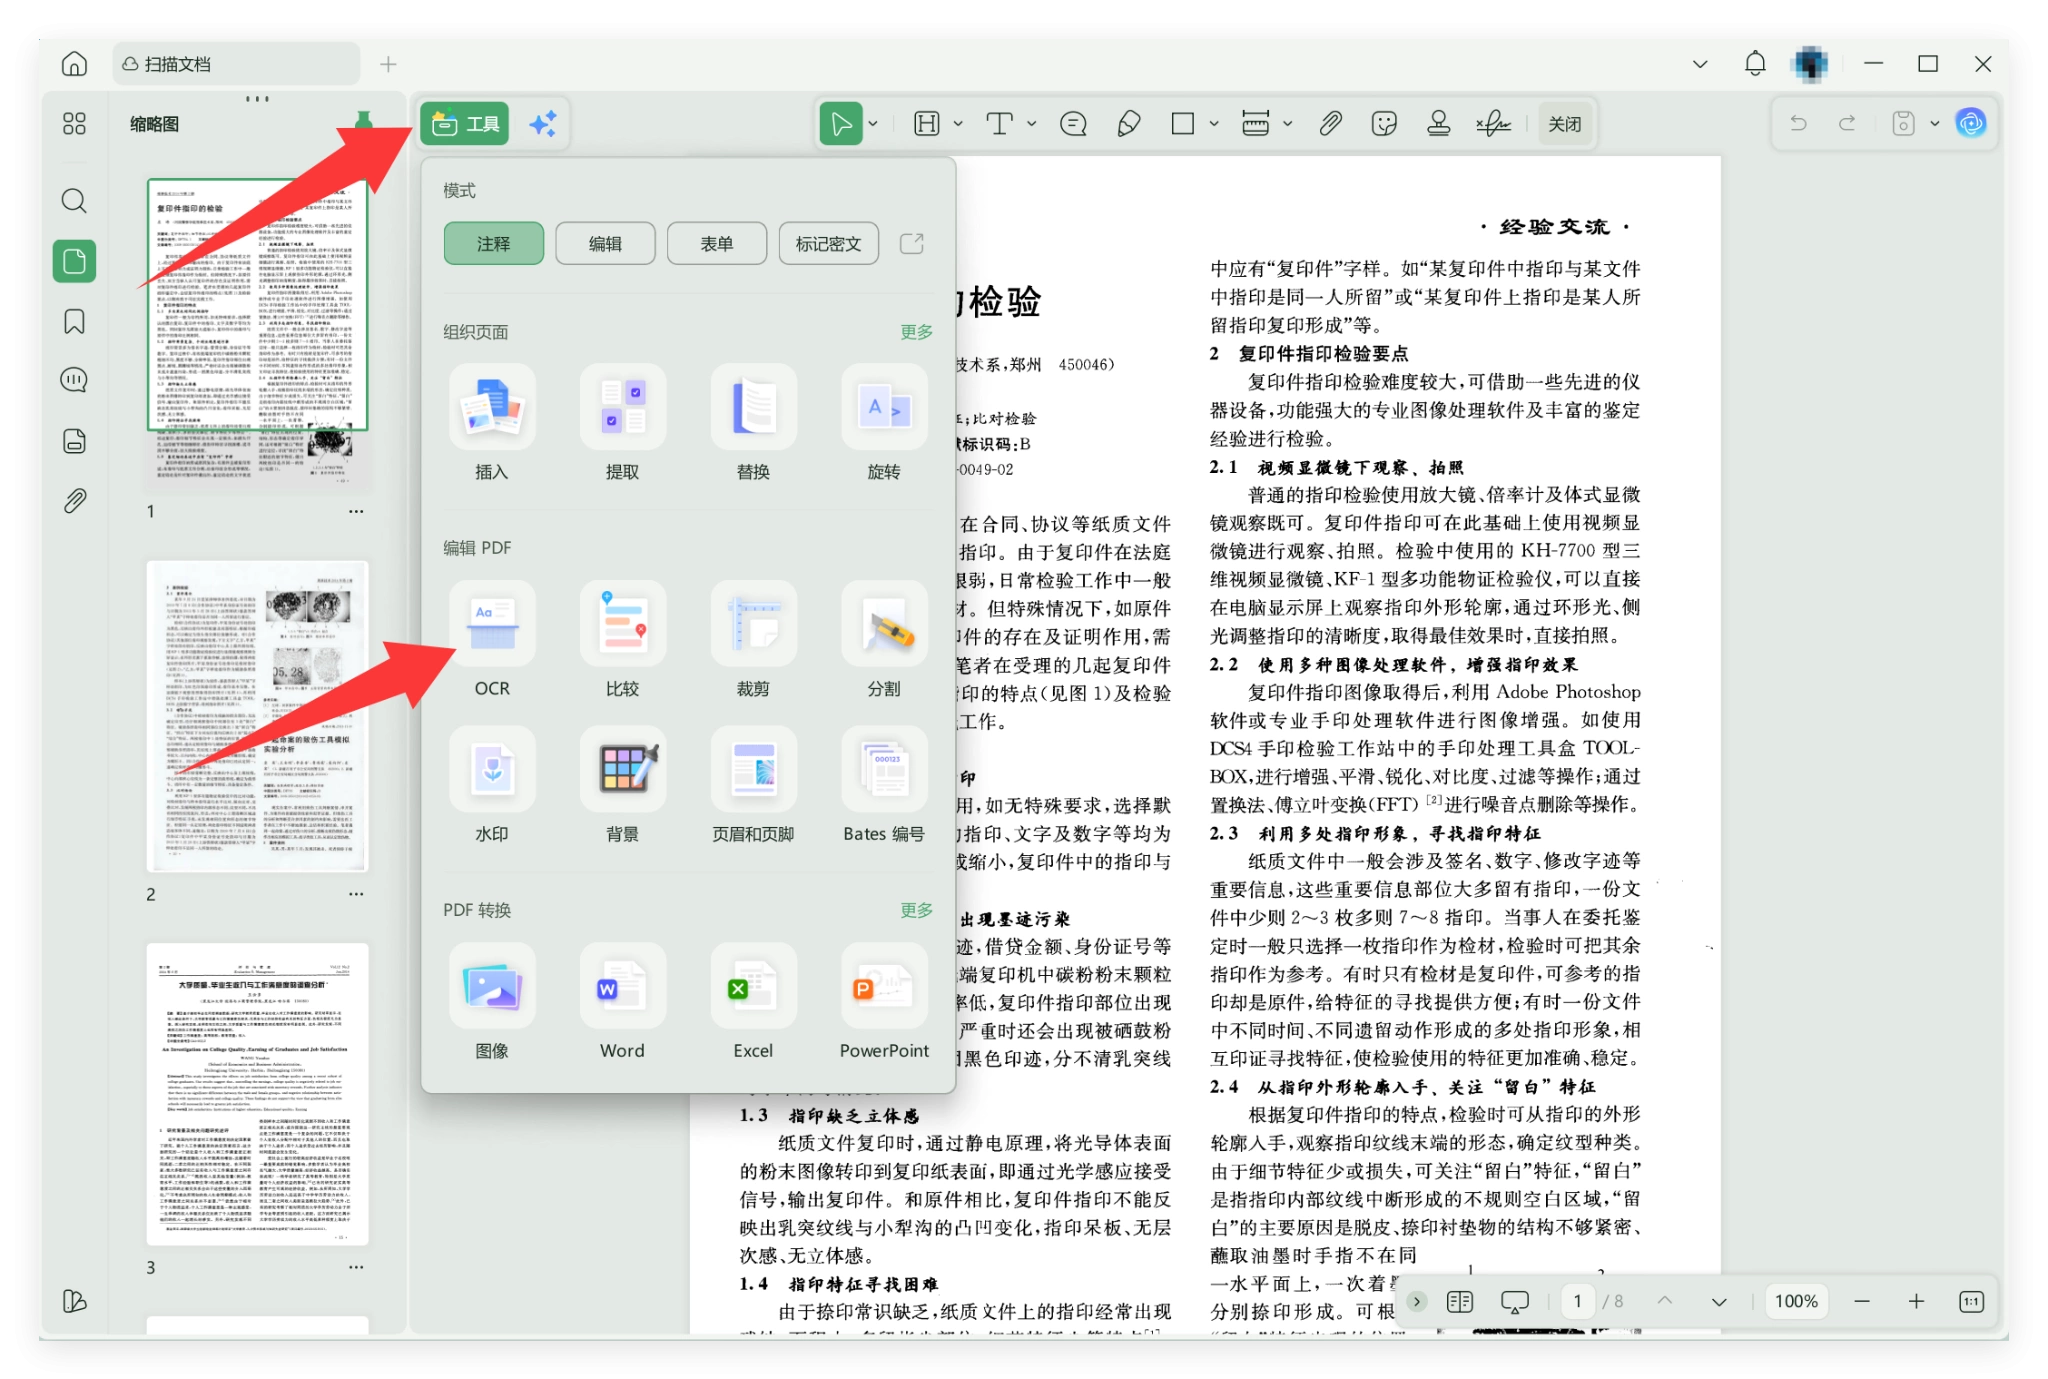
UPDF打开扫描版PDF并进入OCR功能
2. 选择“可编辑PDF(双层OCR)”
如果目标是编辑扫描版PDF,建议选择“可编辑PDF(双层OCR)”。这个模式会尽量保留原页面外观,同时给PDF增加可编辑文本层。
| OCR模式 | 适合场景 |
| 可编辑PDF(双层OCR) | 想修改文字、复制文字、搜索内容 |
| 仅可搜索PDF(双层OCR) | 想保留页面外观,同时让内容可搜索 |
| 仅文本和图片 | 想提取文本和图片内容 |
3. 选择语言和页面范围
中文资料选择简体中文,英文论文选择英文,中英混排文档可以根据主要内容选择语言。页面很多时,可以只识别需要编辑的页;如果整份PDF都是扫描件,就选择全部页面。
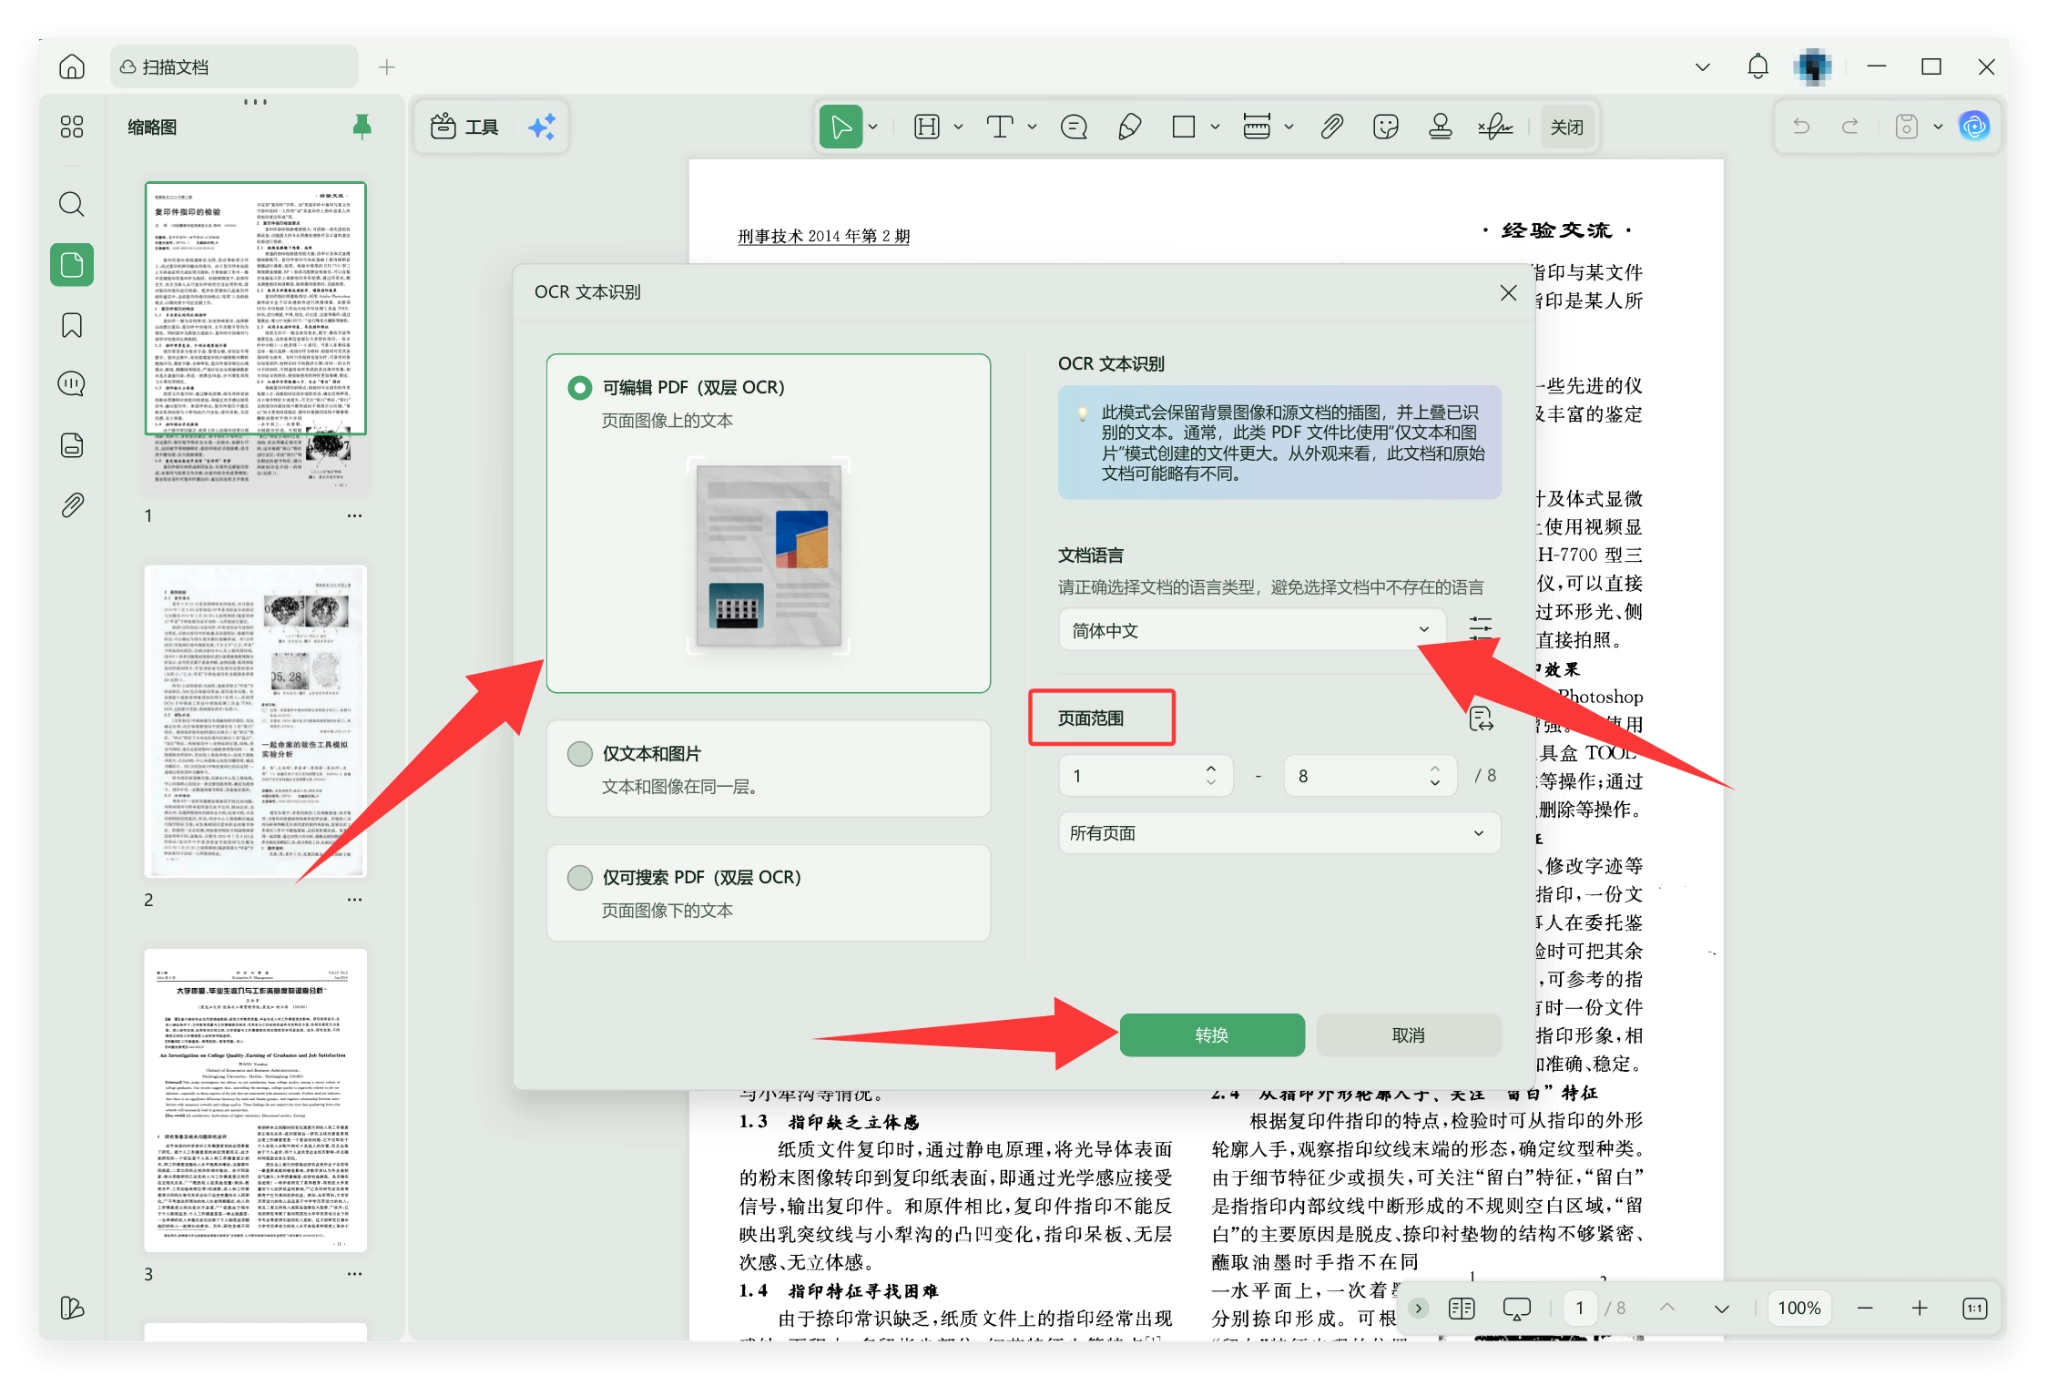
UPDF选择OCR模式、语言和页面范围
4. 点击转换,生成可编辑PDF
设置完成后点击“转换”或“应用”。识别完成后,UPDF会生成带文字层的新PDF。此时你可以重新选中文字、复制内容、搜索关键词,也可以继续修改文字。
三、方法二:从首页工具批量识别扫描版PDF
如果你还没有打开文件,或者手里有多份扫描件,可以从UPDF首页进入OCR批量处理。
1. 从首页进入OCR
打开UPDF后,在首页“工具”区域找到OCR入口。这个方式适合批量处理扫描合同、论文资料、教材章节、证明材料和票据文件。
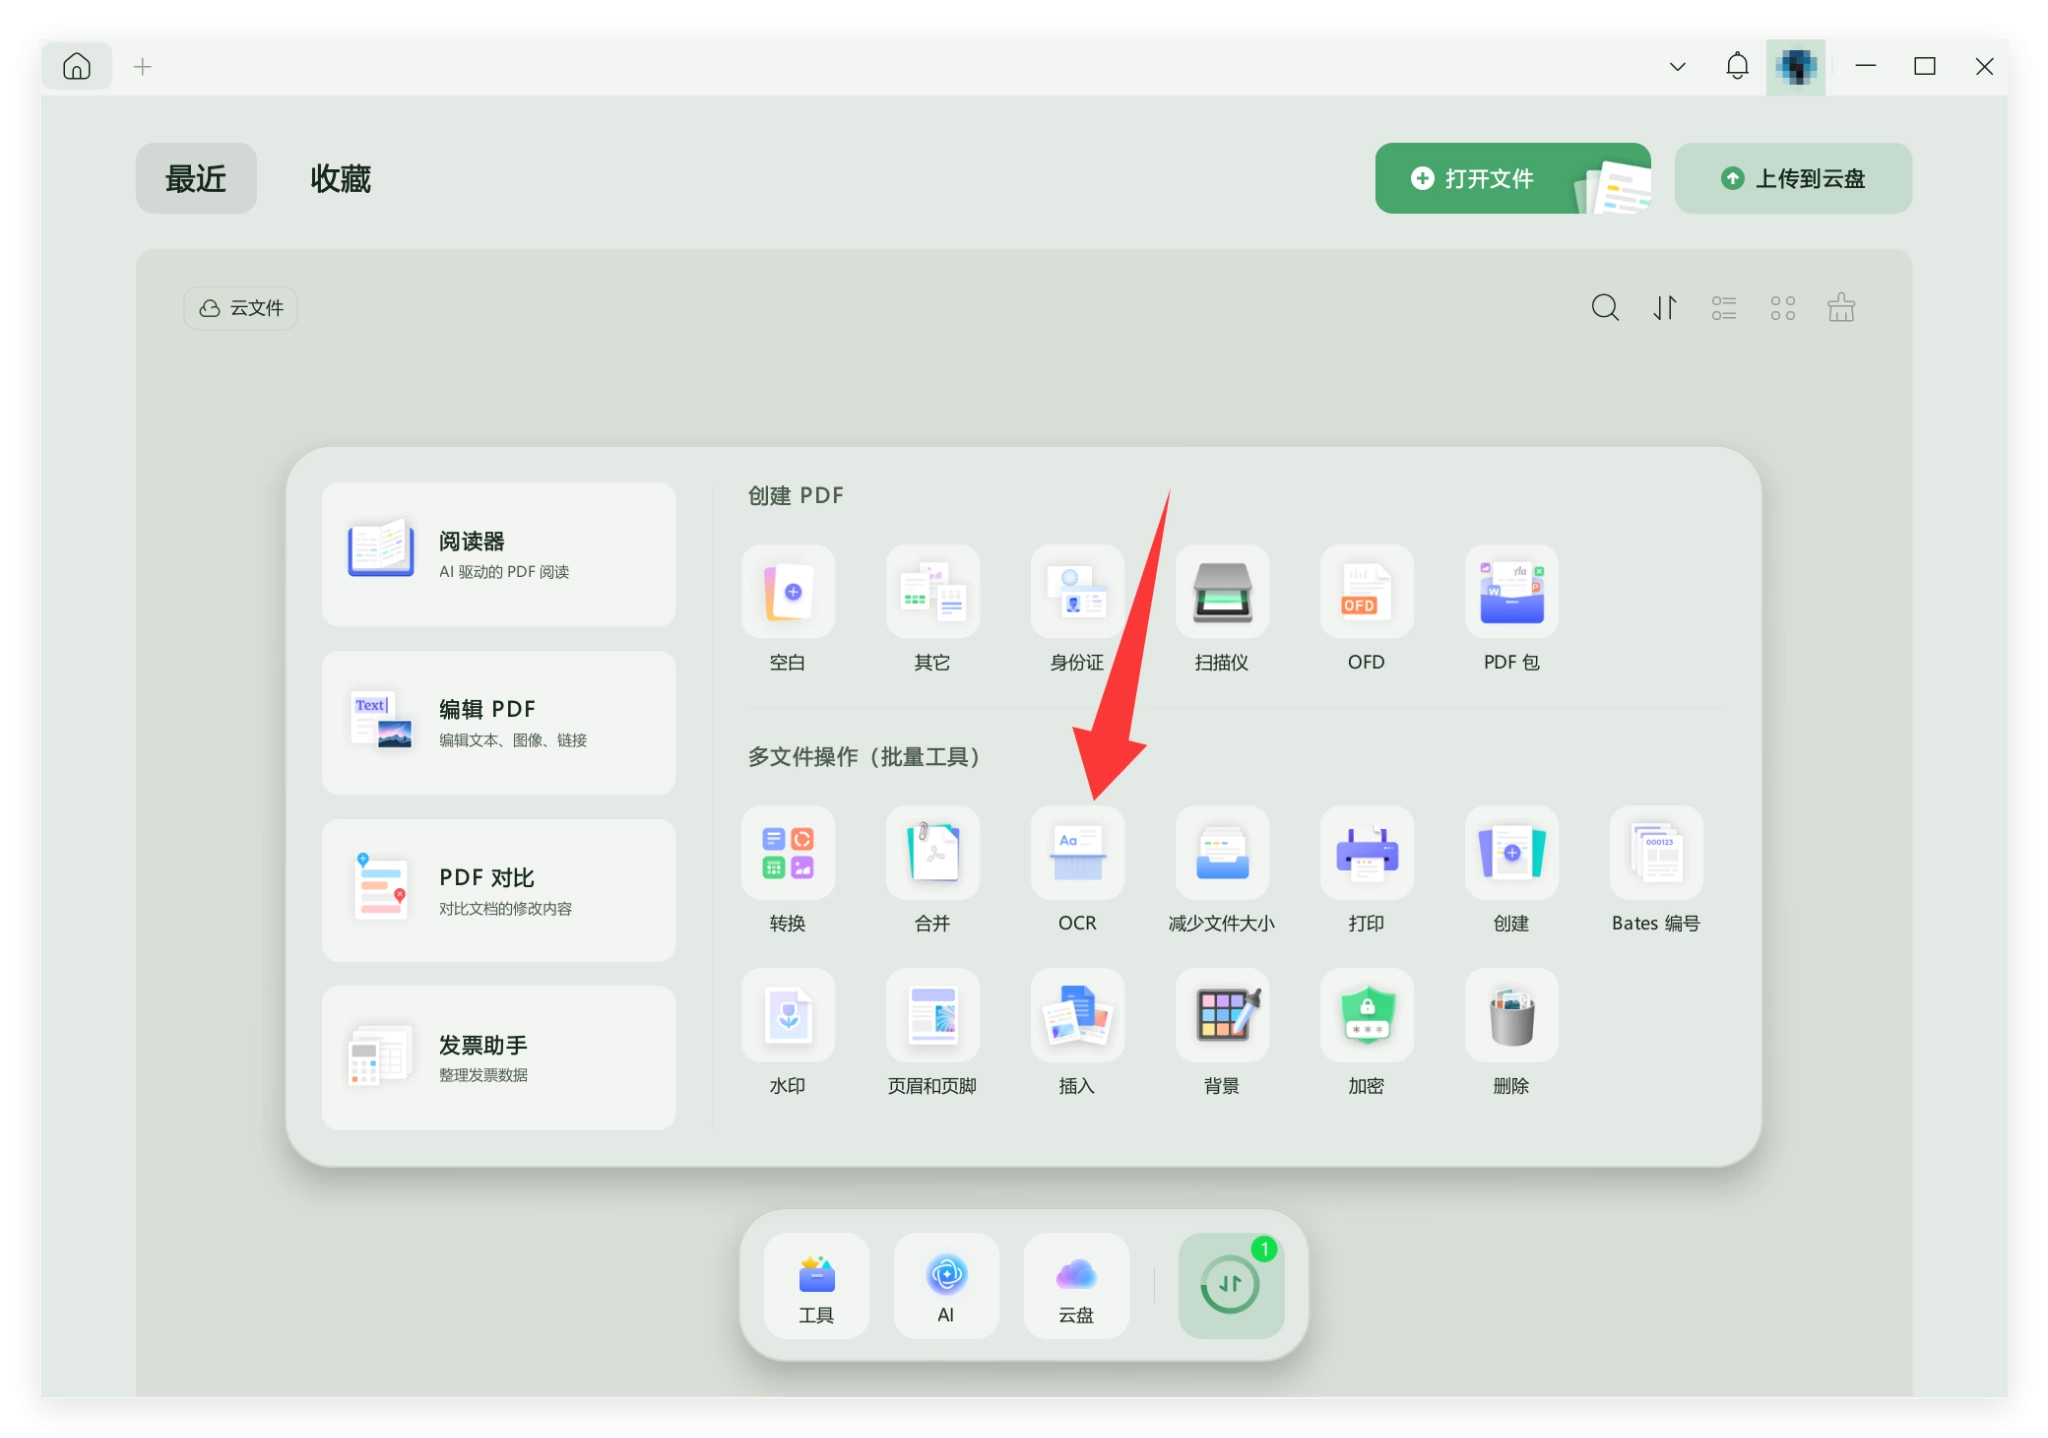
UPDF首页OCR功能入口
2. 添加扫描版PDF文件
进入OCR批量处理界面后,点击“添加文件”,导入需要识别的PDF,也可以把文件拖到页面中间区域。多份文件可以一次添加,统一处理。
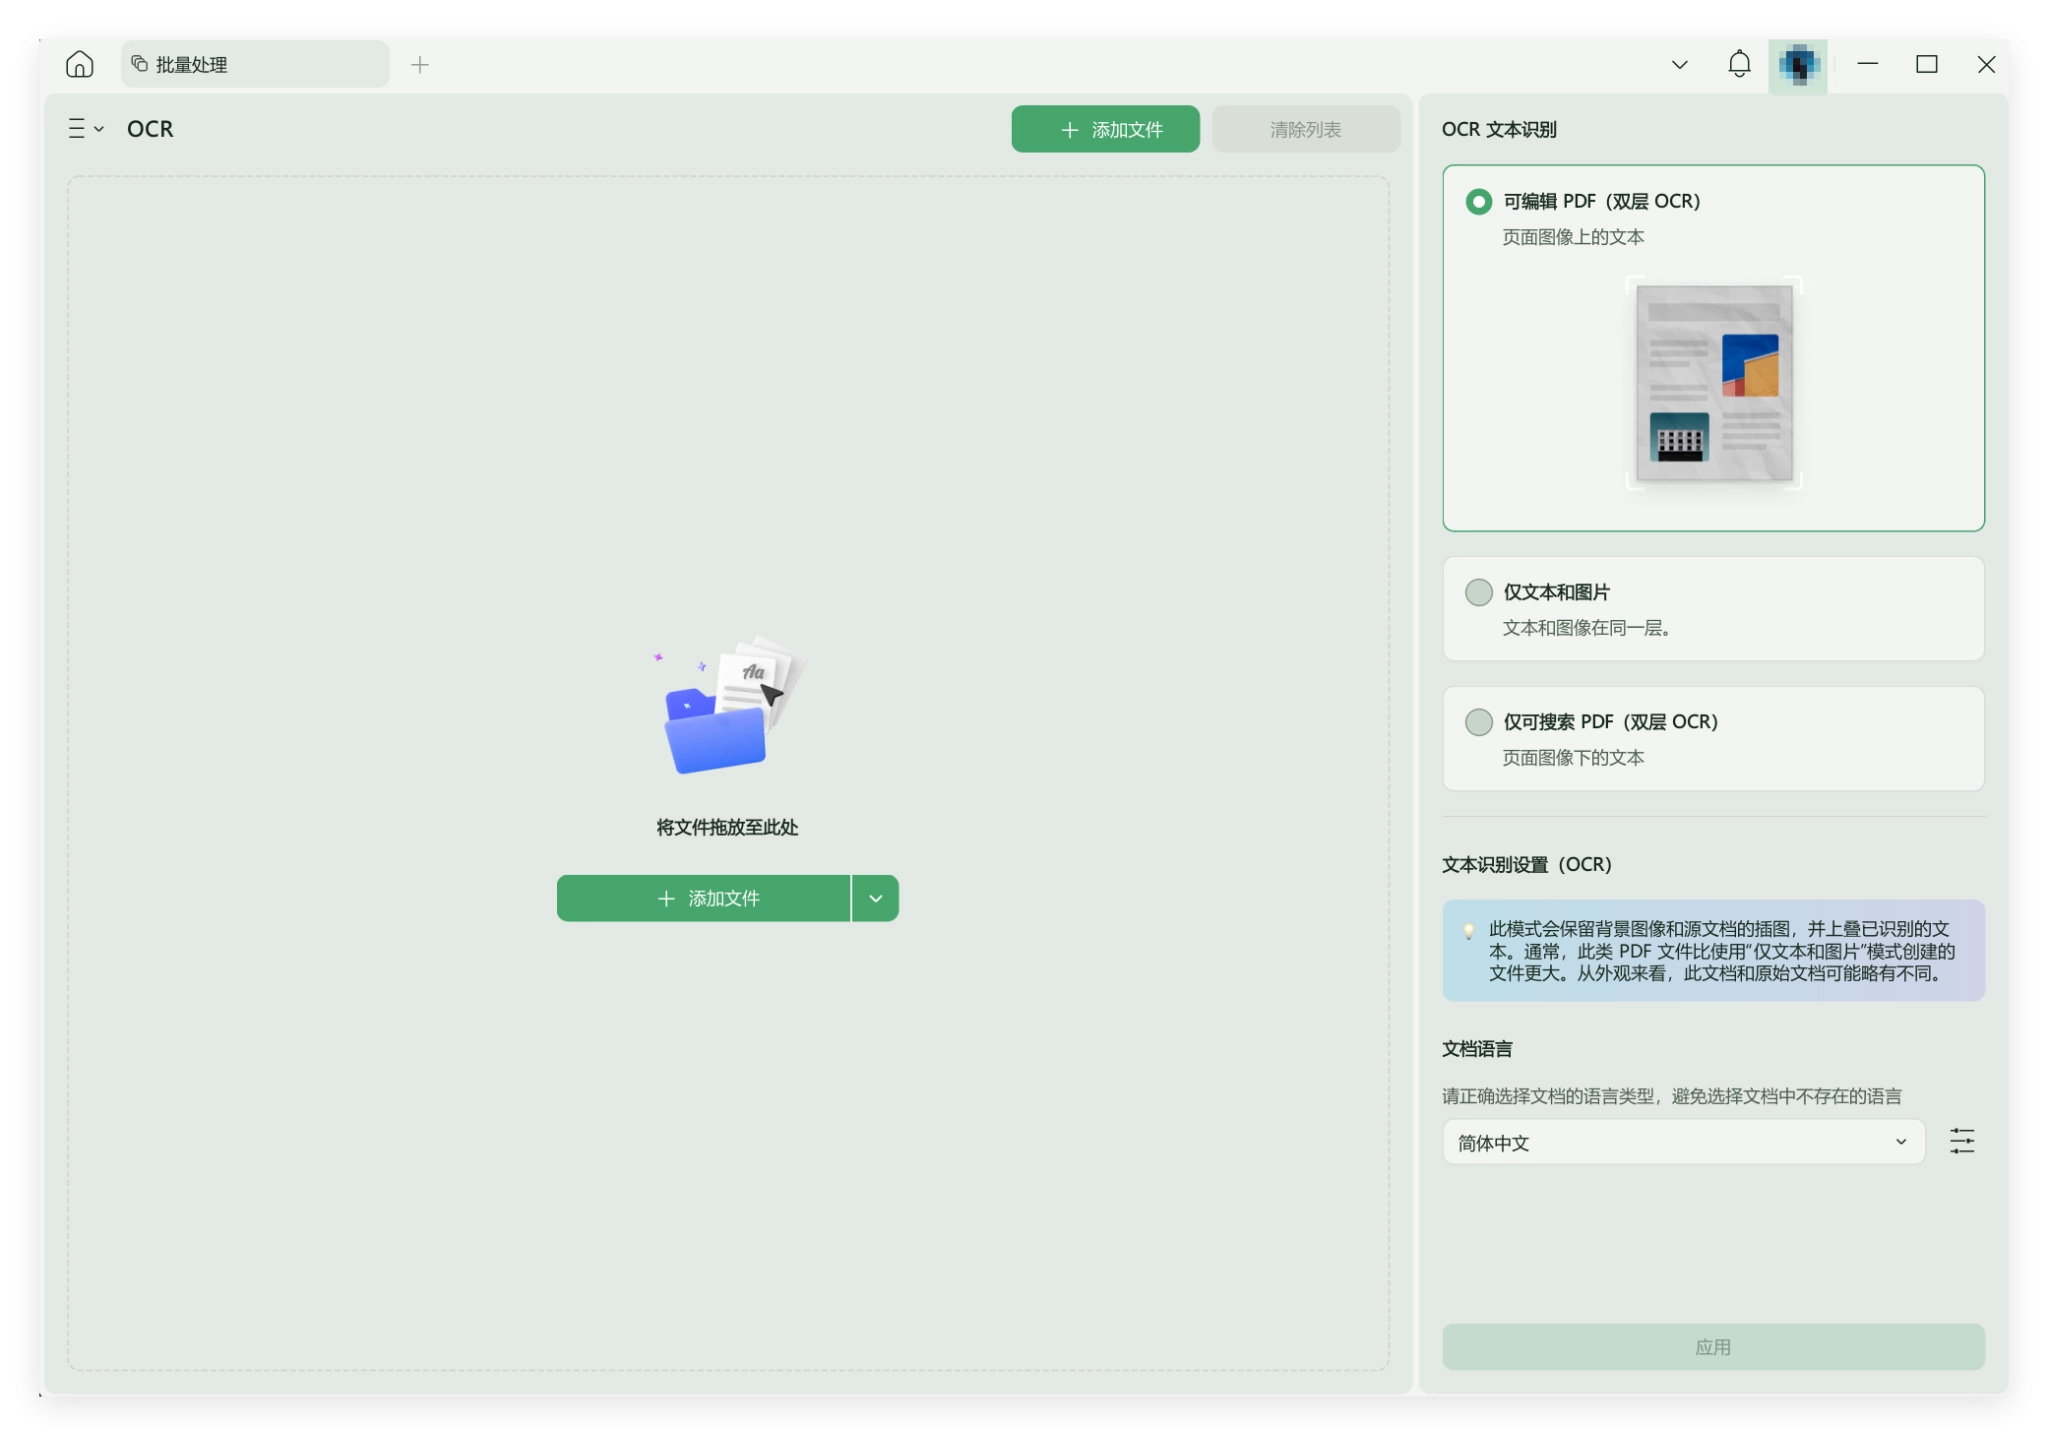
UPDF批量OCR添加扫描版PDF文件
3. 设置OCR参数并应用
右侧选择“可编辑PDF(双层OCR)”,再选择语言和页面范围,最后点击“应用”。识别完成后,新PDF就可以进行文字复制、搜索和编辑。
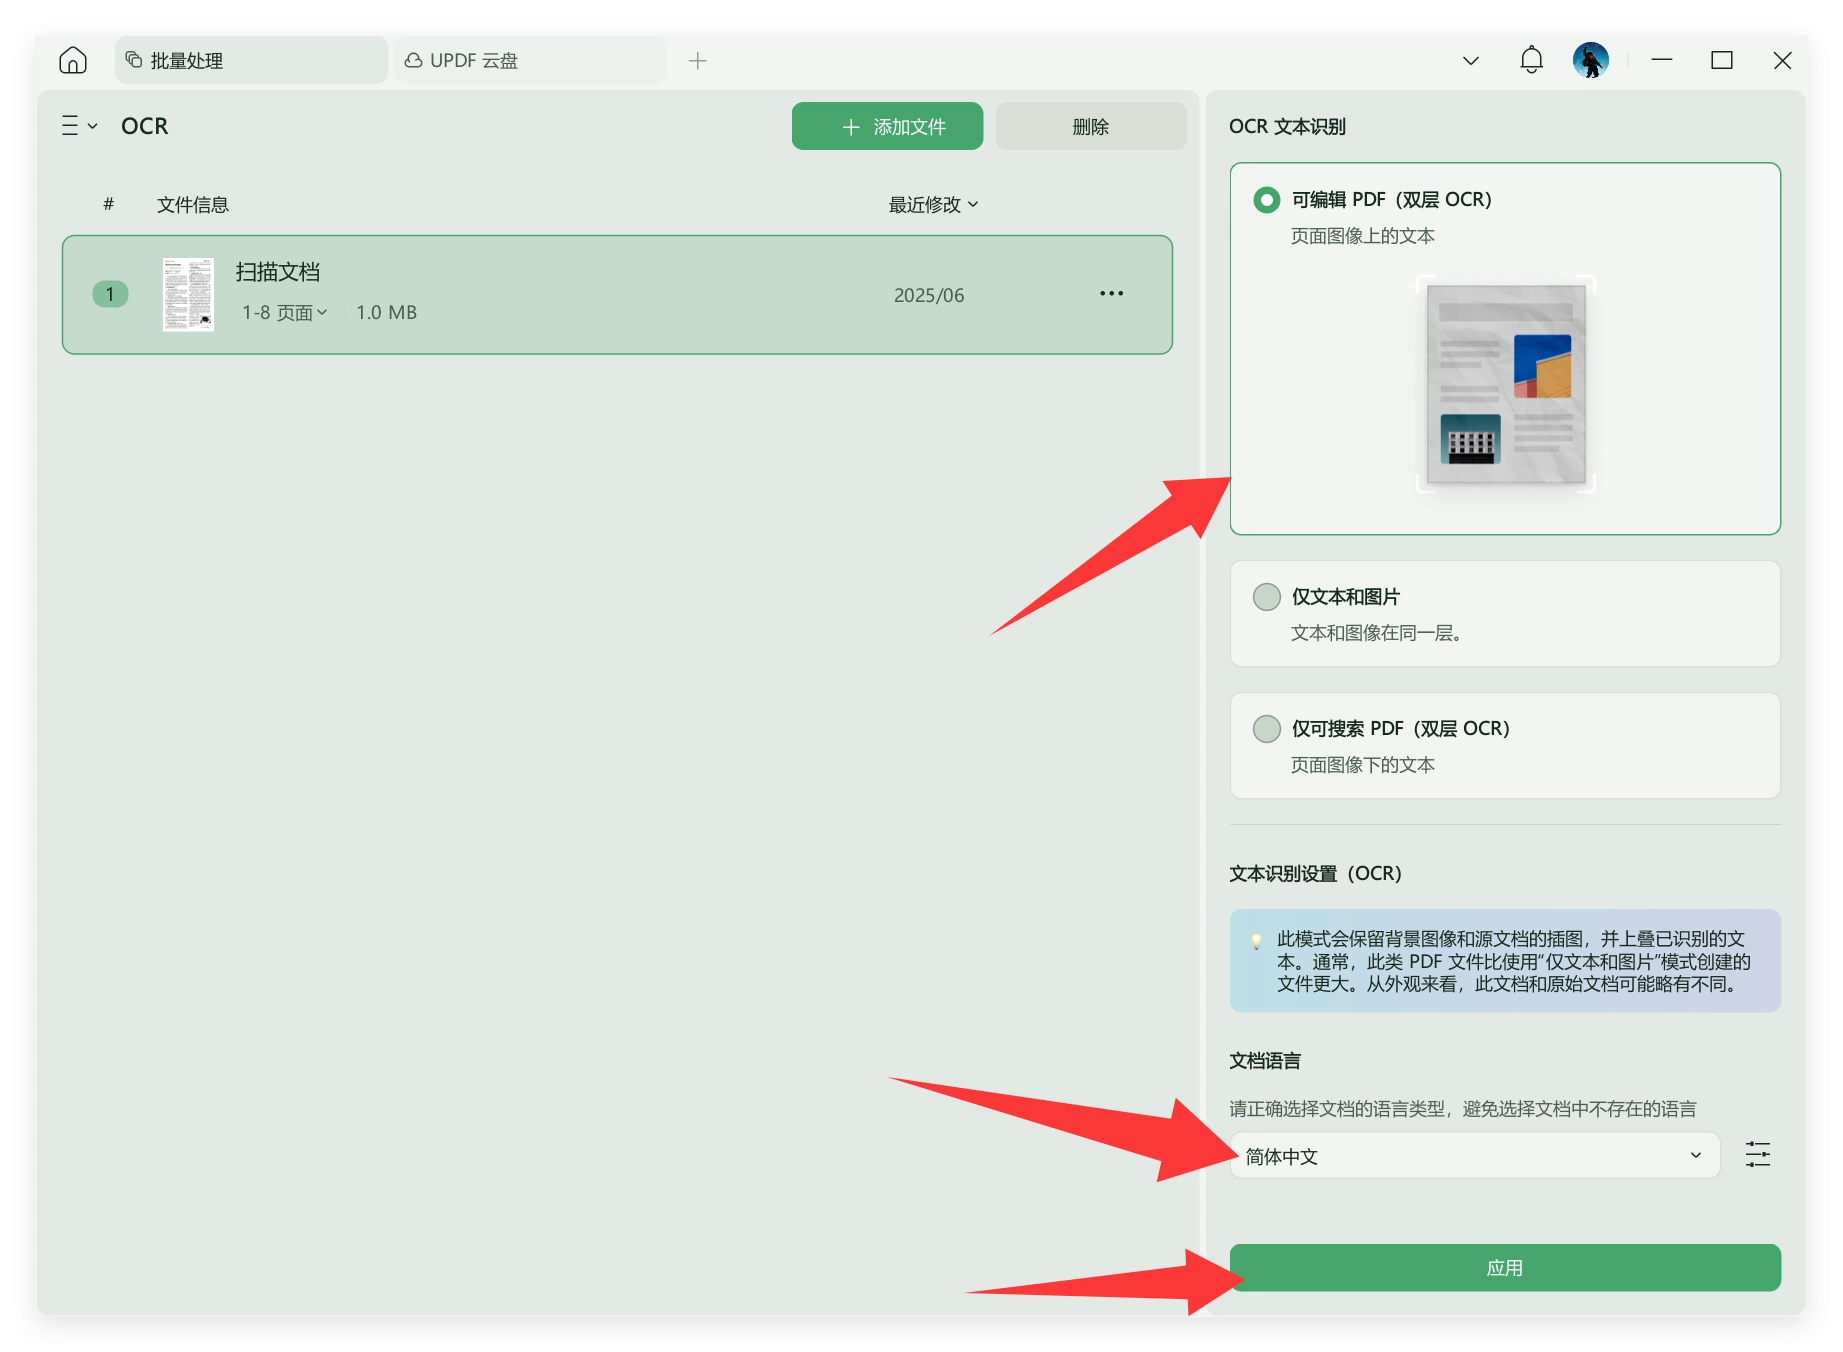
UPDF选择OCR语言并应用识别扫描版PDF
四、OCR识别后可以编辑哪些内容?
1. 修改文字
识别完成后,可以继续修改错别字、日期、姓名、标题、段落内容等。如果只是普通PDF文字编辑,可以查看 PDF修改文字。
2. 复制文字
原本无法选中的扫描文字,OCR后可以被选中和复制,适合论文摘录、合同条款整理、教材笔记和资料归档。
3. 搜索关键词
扫描版PDF最麻烦的是不能搜索。OCR后可以搜索金额、姓名、公司名、专业术语、论文关键词等内容。
4. 转Word继续编辑
如果要大幅修改内容和排版,建议先OCR,再用 PDF转Word。直接把扫描PDF转Word,结果可能仍然是图片,不能正常编辑。
5. 调整页面
扫描件经常有空白页、重复页、页面顺序错误。识别后可以继续删除页面、插入页面、提取指定页面或重新排序。
五、扫描版PDF编辑时要注意什么?
| 注意点 | 说明 |
| 扫描清晰度 | 图片越清晰,OCR识别越稳定。模糊、歪斜、阴影重会影响结果。 |
| 语言选择 | 语言选错会导致错字、乱码、断行异常。 |
| 复杂排版 | 表格、公式、双栏论文、脚注等内容识别后需要人工检查。 |
| 保留原文件 | 建议OCR后另存为新文件,不要覆盖原始扫描件。 |
六、哪些文件适合这样处理?
- 扫描合同:识别后可以搜索金额、日期、条款和责任描述。
- 论文扫描件:识别后可以复制段落、整理引用和阅读笔记。
- 电子教材:识别后可以摘录重点、搜索章节关键词。
- 证明材料:识别后方便提取姓名、编号、日期等信息。
- 发票和票据:识别后可以提取抬头、金额、日期和编号。
七、总结:扫描版PDF怎么编辑?
扫描版PDF不能直接编辑,是因为页面内容通常是图片,没有真实文字层。想编辑扫描版PDF,需要先用UPDF做OCR识别,建议选择“可编辑PDF(双层OCR)”,再选择语言和页面范围,点击转换或应用。
识别完成后,扫描版PDF就可以继续复制文字、搜索关键词、修改内容、转Word或整理页面。对于合同、论文、教材、证明材料和票据文件,OCR是从“只能看”变成“可编辑”的关键步骤。
FAQ:扫描版PDF编辑常见问题
1. 扫描版pdf怎么编辑?
先用UPDF OCR识别,把图片文字转换成可编辑文本,再继续修改文字、复制内容、搜索关键词或转Word。
2. 扫描版PDF为什么文字点不动?
因为页面内容通常是图片,没有真实文本层,所以普通编辑功能无法直接选中文字。
3. 扫描版PDF可以直接转Word吗?
可以,但建议先OCR再转Word。否则转出的Word可能仍然是图片,无法编辑文字。
4. OCR后还需要检查吗?
需要。表格、公式、双栏论文和模糊扫描件可能出现识别误差,重点内容要人工核对。